Durch die Bereitstellung der GPT-Technologie in einem leistungsstarken, benutzerfreundlichen Chatbot ist ChatGPT zum beliebtesten KI-Modell der Welt geworden. Viele Menschen nutzen es, um spannende Gespräche zu beginnen, Fragen zu beantworten, kreative Vorschläge zu machen und beim Programmieren und Schreiben zu helfen. ChatGPT ist jedoch insofern eingeschränkt, als Sie Ihre Daten nicht für den langfristigen persönlichen Gebrauch speichern können, und der größte Nachteil besteht darin, dass es bis September 2021 für Wissensdaten verfügbar ist.
Alternativ können APIs von OpenAI und LangChain verwendet werden, um ChatGPT nach 2021 mit benutzerdefinierten Daten und aktualisierten Informationen zu versorgen und eine benutzerdefinierte ChatGPT-Instanz zu erstellen. Verifizieren ChatGPT vs. Google Gemini: Welches Modell eignet sich besser zum Programmieren?
Schnelle Links
Warum sollten Sie ein ChatGPT mit benutzerdefinierten Daten erstellen?
Das Füttern von ChatGPT mit benutzerdefinierten Daten und die Bereitstellung aktueller Informationen über das Ablaufdatum des Wissens hinaus bietet viele Vorteile gegenüber der einfachen Verwendung von ChatGPT wie gewohnt. Hier sind einige davon:
- Spezifische InteraktionenIndem ChatGPT mit benutzerdefinierten Daten versorgt wird, können Benutzer ein personalisierteres Erlebnis schaffen. Das Modell kann anhand spezifischer Datensätze trainiert werden, die für einzelne Benutzer oder Organisationen relevant sind, was zu Antworten führt, die auf deren individuelle Bedürfnisse und Vorlieben zugeschnitten sind.
- Fachspezifische Erfahrung: Durch die benutzerdefinierte Datenintegration kann sich ChatGPT auf bestimmte Bereiche oder Branchen spezialisieren. Es kann auf branchenspezifisches Wissen, Terminologie und Trends geschult werden, was genauere und detailliertere Antworten in diesen spezifischen Bereichen ermöglicht.
- Aktuelle und genaue Informationen: Der Zugriff auf aktuelle Informationen stellt sicher, dass ChatGPT über die neuesten Entwicklungen und Erkenntnisse auf dem Laufenden bleibt. Es kann genaue Antworten auf der Grundlage aktueller Ereignisse, Nachrichten oder Forschungsergebnisse liefern und ist somit eine zuverlässigere Informationsquelle.
Nachdem Sie nun verstanden haben, wie wichtig die Bereitstellung benutzerdefinierter Daten für ChatGPT ist, finden Sie hier eine Schritt-für-Schritt-Anleitung, wie Sie dies auf Ihrem lokalen Computer tun.
Schritt 1: Vorgefertigte Anwendungen und Skripte installieren und herunterladen
Bitte beachten Sie, dass die folgenden Anweisungen für ein Windows 10- oder Windows 11-Gerät gelten.
Um benutzerdefinierte Daten für ChatGPT bereitzustellen, müssen Sie die neueste Version von Python3, Git, Microsoft C++ und das ChatGPT-Wiederherstellungsskript von GitHub installieren und herunterladen. Wenn Sie bereits einige Anwendungen auf Ihrem Computer installiert haben, aktualisieren Sie diese unbedingt auf die neueste Version, um Probleme während des Vorgangs zu vermeiden.
Beginnen Sie mit der Installation:
herunterladen:Python3 (Kostenlos)
herunterladen:Git (Kostenlos)
herunterladen:Microsoft Visual Build Tools (Kostenlos)



Hinweise zur Installation von Python3 und Microsoft C++
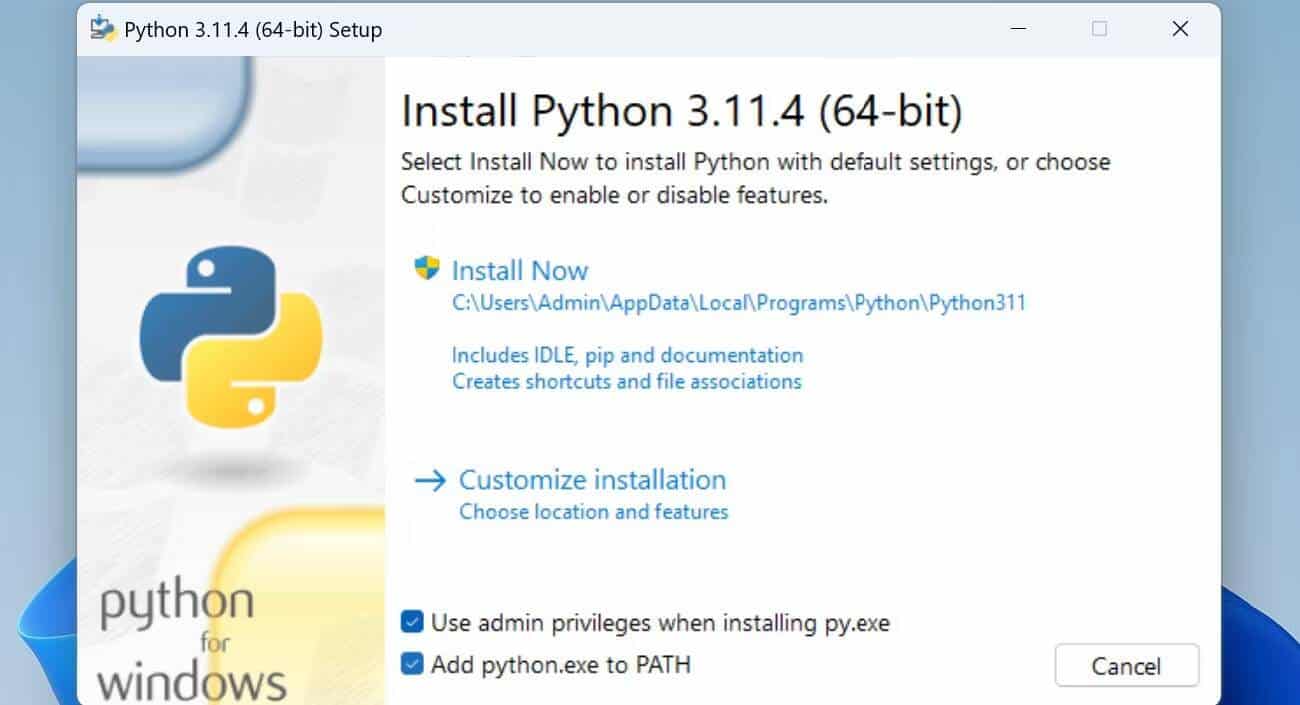
Stellen Sie bei der Installation von Python3 sicher, dass Sie die Option auswählen Fügen Sie python.exe zu PATH hinzu bevor Sie klicken JETZT INSTALLIEREN. Dies ist wichtig, da Sie damit in jedem Verzeichnis auf Ihrem Computer auf Python zugreifen können.
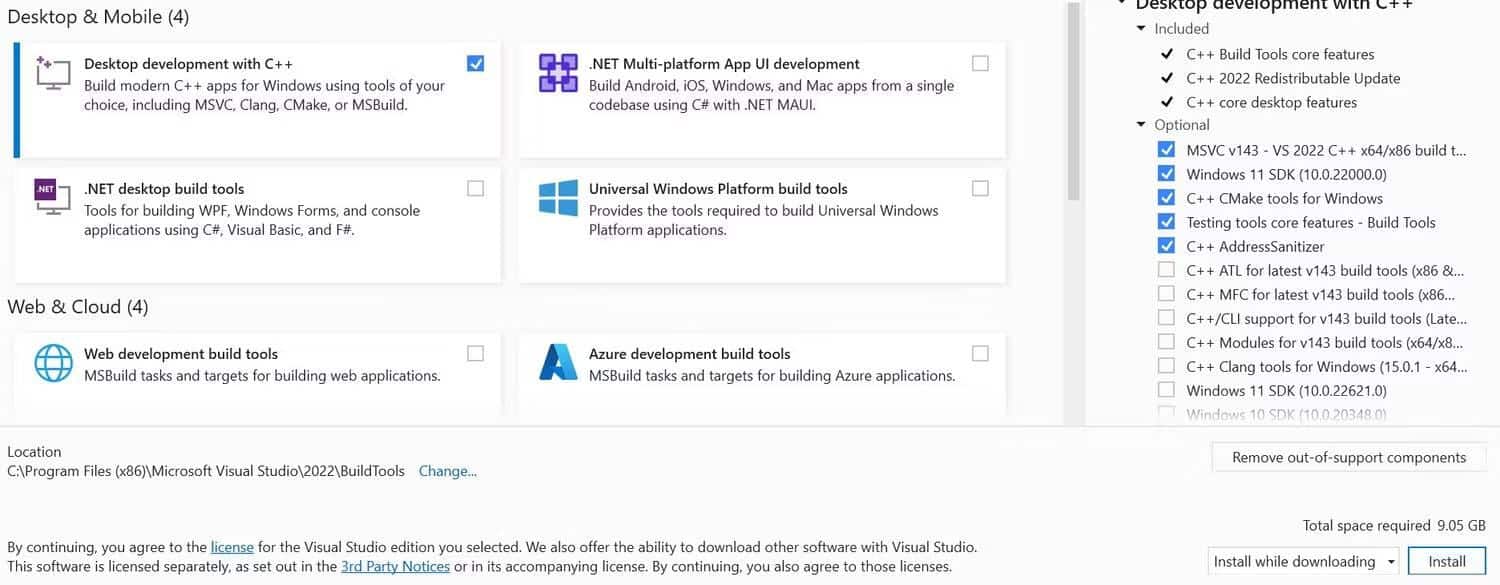
Bei der Installation von Microsoft C++ müssen Sie zuerst die Microsoft Visual Studio Build Tools installieren. Nach der Installation können Sie die Option „Desktop-Entwicklung mit C++“ auswählen und auf „Installieren“ klicken, wobei alle optionalen Tools automatisch in der rechten Seitenleiste ausgewählt werden.
Nachdem Sie nun die neuesten Versionen von Python3, Git und Microsoft C++ installiert haben, können Sie ein Python-Skript herunterladen, um lokale, benutzerdefinierte Daten einfach abzufragen.
herunterladen:ChatGPT-Abrufskript (Kostenlos)
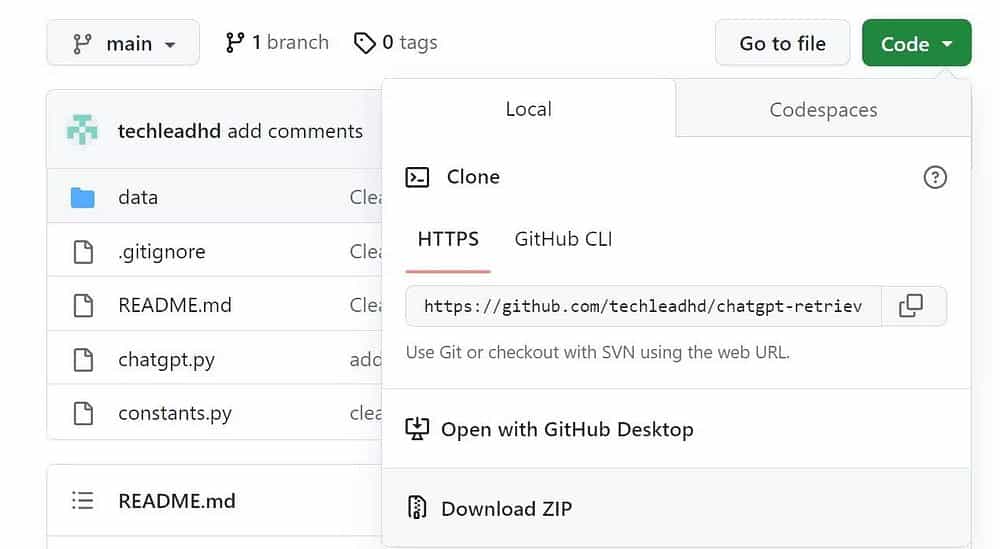
Um das Skript herunterzuladen, klicken Sie auf Code , Dann wählen Sie ZIP herunterladen. Dadurch sollte das Python-Skript in das Standardverzeichnis oder das angegebene Verzeichnis heruntergeladen werden.
Nach dem Herunterladen können wir nun eine lokale Umgebung einrichten. Verifizieren So beherrschen Sie mit ChatGPT die Kunst des Geschichtenerzählens.
Schritt 2: Bereiten Sie die lokale Umgebung vor
Um die Umgebung einzurichten, müssen Sie Terminal im heruntergeladenen Ordner chatgpt-recovery-main öffnen. Öffnen Sie dazu den Ordner „chatgpt-recovery-main“, klicken Sie mit der rechten Maustaste und wählen Sie „ Im Terminal öffnen.
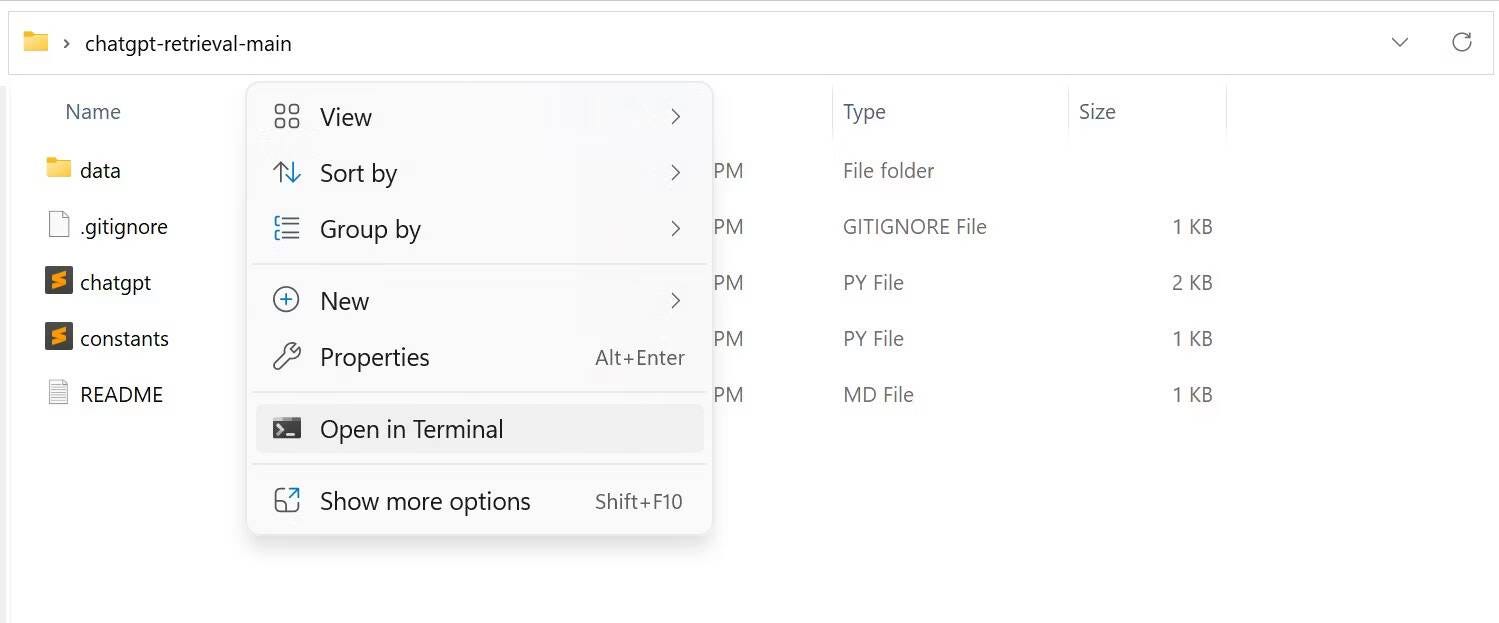
Sobald Terminal geöffnet ist, kopieren Sie diesen Befehl und fügen Sie ihn ein:
pip install langchain openai chromadb tiktoken unstructured
Dieser Befehl verwendet den Python-Paketmanager, um die erforderliche virtuelle Python-Umgebung zu erstellen und zu verwalten.
Nachdem wir die virtuelle Umgebung erstellt haben, müssen wir einen API-Schlüssel von OpenAI bereitstellen, um auf seine Dienste zuzugreifen. Wir müssen zunächst einen API-Schlüssel von einer Schlüsselseite generieren OpenAI-API Beim Klicken Erstellen Sie einen neuen geheimen Schlüssel , geben Sie der Taste einen Namen und drücken Sie dann eine Taste Erstellen Sie einen geheimen Schlüssel.
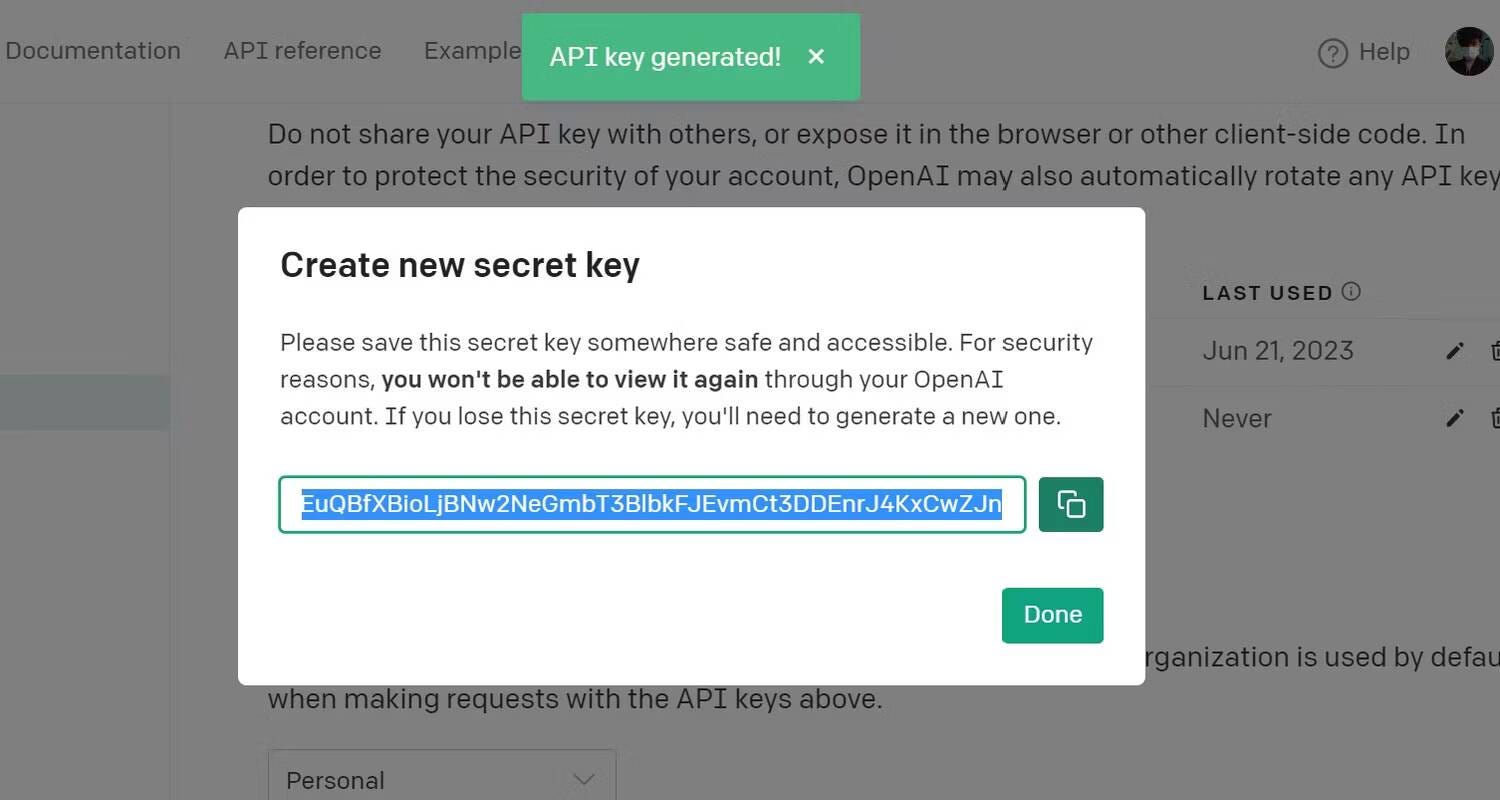
Sie erhalten eine Zeichenfolge. Dies ist Ihr OpenAI-API-Schlüssel. Kopieren Sie es, indem Sie auf das Kopiersymbol neben dem API-Schlüssel klicken. Beachten Sie, dass der API-Schlüssel geheim bleiben muss. Teilen Sie es nicht mit anderen, es sei denn, Sie beabsichtigen tatsächlich, dass diese es mit Ihnen verwenden.
Gehen Sie nach dem Kopieren zurück zum Ordner chatgpt-recovery-main und öffnen Sie die Constants-Datei mit Notepad. Ersetzen Sie nun den Platzhalter durch Ihren API-Schlüssel. Denken Sie daran, die Datei zu speichern!
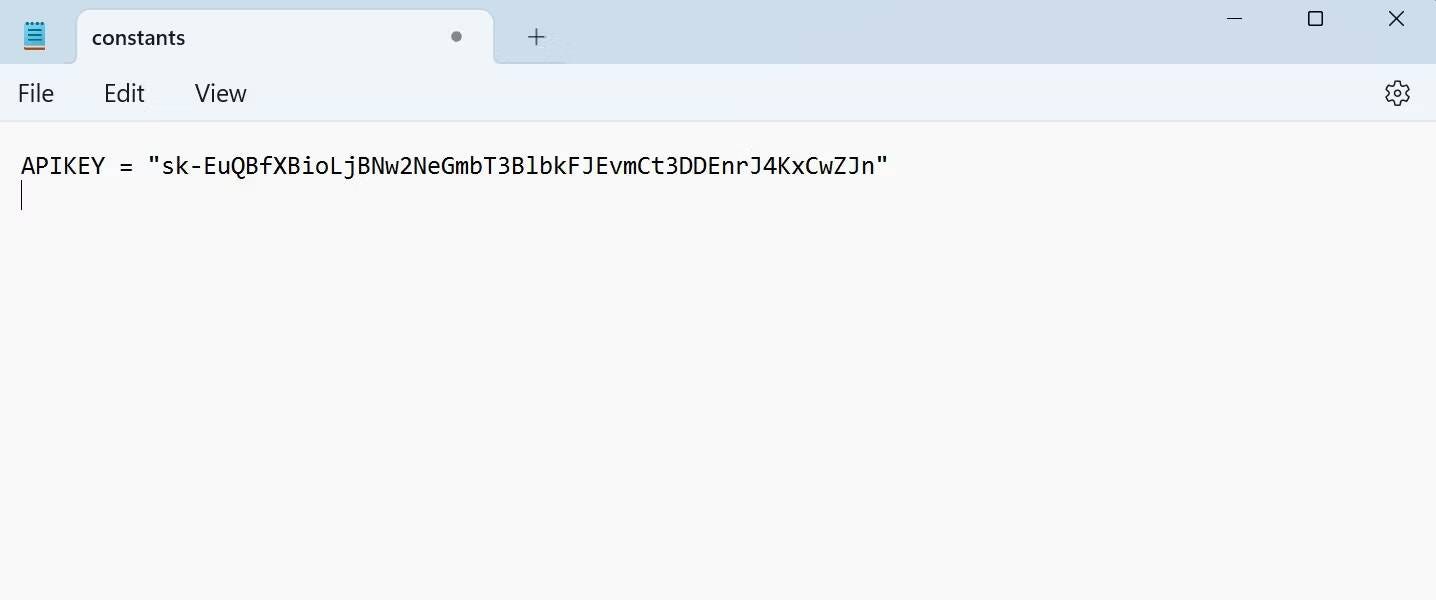
Jetzt haben Sie Ihre virtuelle Umgebung erfolgreich eingerichtet und Ihren OpenAI-API-Schlüssel als Umgebungsvariable hinzugefügt. Sie können ChatGPT jetzt Ihre benutzerdefinierten Daten bereitstellen.
Schritt 3: Benutzerdefinierte Daten hinzufügen
Um benutzerdefinierte Daten hinzuzufügen, platzieren Sie alle Ihre benutzerdefinierten Textdaten im Datenordner in chatgpt-recovery-main. Das Textdatenformat kann im PDF-, TXT- oder DOC-Format vorliegen.
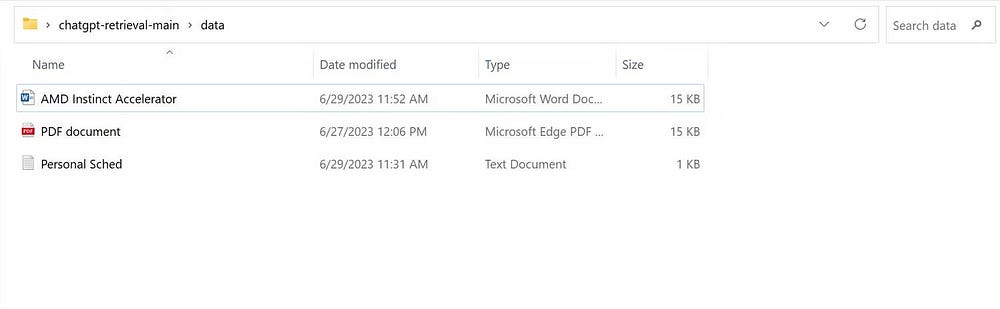
Wie Sie dem Screenshot oben entnehmen können, habe ich eine Textdatei hinzugefügt, die eine konfigurierte persönliche Tabelle und einen Artikel enthält, über den ich geschrieben habe AMD Instinct-Beschleuniger und PDF-Dokument.
Schritt 4: Informationen mit ChatGPT über das Terminal abfragen
Mit dem Python-Skript können wir Informationen aus benutzerdefinierten Daten abfragen, die wir dem Ordner „Daten und Internet“ hinzugefügt haben. Mit anderen Worten: Sie haben Zugriff auf das übliche ChatGPT-Backend und alle lokal im Datenordner gespeicherten Daten.
Um das Skript zu verwenden, führen Sie es aus chatgpt.py Fügen Sie dann Ihre Frage oder Anfrage als Argument hinzu.
python chatgpt.py „IHRE FRAGE“
Stellen Sie sicher, dass Sie Ihre Fragen in Anführungszeichen setzen.
Um zu testen, ob wir ChatGPT unsere Daten erfolgreich eingegeben haben, werde ich eine persönliche Frage zum Sched.txt-Profil stellen.
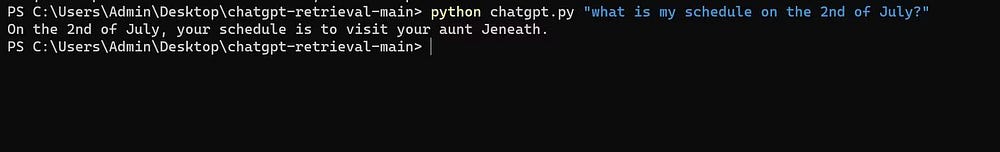
Das Modell hat funktioniert! Dies bedeutet, dass ChatGPT das zuvor bereitgestellte Profil lesen konnte. Sehen wir uns nun an, ob es uns gelungen ist, ChatGPT-Informationen bereitzustellen, die aufgrund des Ausfalldatums der Wissensdatenbank nicht bekannt sind.
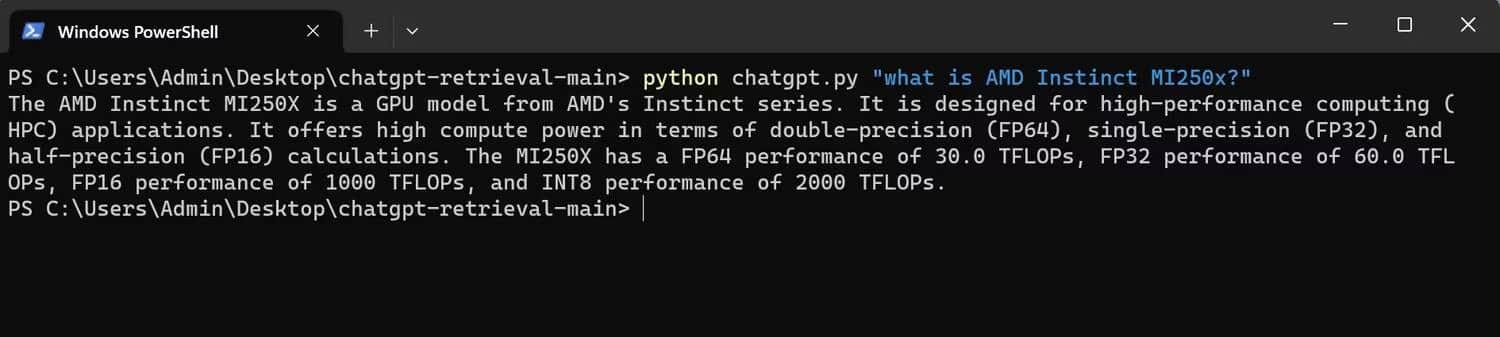
Wie Sie sehen können, wurde der AMD Instinct MI250x korrekt beschrieben, der nach dem Stichtag -3 der ChatGPT-Wissensdatenbank veröffentlicht wurde.
Grenzen einer dedizierten ChatGPT-Instanz
Obwohl die Einspeisung benutzerdefinierter GPT-3.5-Daten mehr Möglichkeiten zur Implementierung und Nutzung von LLM eröffnet, gibt es einige Nachteile und Einschränkungen.
Zunächst müssen Sie alle Daten selbst bereitstellen. Bis zum Ablaufdatum des Wissens können Sie weiterhin auf das gesamte GPT-3.5-Wissen zugreifen. Allerdings müssen Sie alle weiteren Daten angeben. Das heißt, wenn Sie möchten, dass Ihr lokales Modell über ein bestimmtes Thema im Internet Bescheid weiß, das GPT-3.5 noch nicht kennt, müssen Sie online gehen, die Daten selbst auslesen und als Text im Chatgpt speichern. Wiederherstellungs-Hauptdatenordner.
Ein weiteres Problem besteht darin, dass das Laden einer benutzerdefinierten Abfrage auf ChatGPT im Vergleich zu einer direkten ChatGPT-Abfrage länger dauert.
Schließlich ist das einzige derzeit verfügbare Modell der GPT-3.5 Turbo. Selbst wenn Sie also Zugriff auf GPT-4 haben, können Sie damit nicht Ihre eigene benutzerdefinierte ChatGPT-Instanz ausführen. Verifizieren Anwendungen, die das GPT-4-Modell in ihren Kern integriert haben, aber wie funktionieren sie?
Der personalisierte Chat ist großartig, aber begrenzt
Die Bereitstellung benutzerdefinierter Daten für ChatGPT ist eine effektive Möglichkeit, das Beste aus Ihrem Modell herauszuholen. Mit dieser Methode können Sie dem Formular beliebige Textdaten zuführen und diese wie bei regulärem ChatGPT beanspruchen, allerdings mit einigen Einschränkungen. Dies wird sich jedoch in Zukunft ändern, da es einfacher wird, unsere Daten in LLM zu integrieren und auf das neueste GPT-4-Modell zuzugreifen. Sie können es jetzt ansehen Signalisiert, dass Sie mit einem KI-Bot sprechen.