Mit dem Aufkommen fortschrittlicher KI-Technologien gibt es mehrere Versionen von Sprachmodellen wie ChatGPT, Gemeni und Claude, jedes mit seinen eigenen Funktionen. Wenn Sie den Unterschied zwischen diesen Modellen verstehen, können Sie das Modell auswählen, das den unterschiedlichen Anforderungen am besten entspricht, sei es für den persönlichen oder beruflichen Gebrauch.
Da GPT-4o im Mai 2024 als Ergänzung zu GPT-4 veröffentlicht wird, fragen Sie sich möglicherweise, was der Unterschied zwischen den in ChatGPT integrierten KI-Modellen ist und welche Sie tatsächlich verwenden sollten. Obwohl die GPT-4-Modelle von OpenAI auf derselben Grundlage basieren, weisen sie einige große Unterschiede auf, die bedeuten, dass sie für einige Aufgaben besser geeignet sind als andere, ganz zu schweigen von den Kosten, die mit dem Zugriff darauf verbunden sind. verifizieren Entdecken Sie Möglichkeiten, kostenlos auf GPT-4 zuzugreifen.

Was ist also der Unterschied zwischen den GPT-4-Modellen von OpenAI?
Was ist der Unterschied zwischen GPT-4, GPT-4o und GPT-4o mini?
Die GPT-4-Modelle von OpenAI umfassen mehrere Varianten, die jeweils auf unterschiedliche Anforderungen zugeschnitten sind. Hier finden Sie eine Übersicht über die Unterschiede zwischen GPT-4, GPT-4o (Omni) und GPT-4o mini.
GPT-4
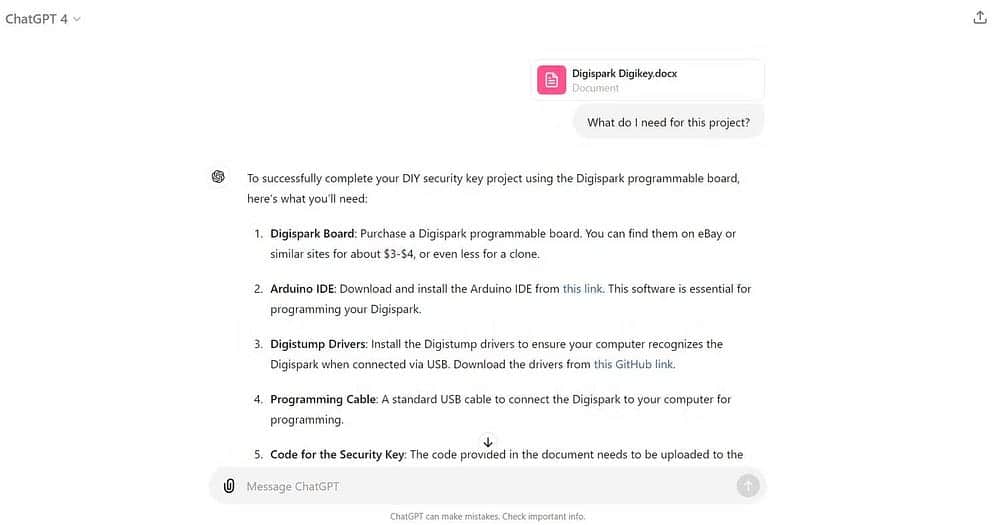
GPT-4 ist das Basismodell. Es versteht und generiert komplexe Sätze und ist für eine Vielzahl von Anwendungen nützlich, beispielsweise für kreatives Schreiben, Datenanalyse, Sprachübersetzung und Codegenerierung. Mit einem GPT-4-Kontextfenster mit 23000 bis 25000 Wörtern können Sie auch mehrere lange Dokumente anhängen und alle Fragen zu den von Ihnen hochgeladenen Dateien beantworten. Da es sich um das Basismodell der Serie handelt, haben Sie auch Zugriff auf alle nützlichen GPT-4-Funktionen sowohl beim GPT-4 Turbo als auch beim GPT-4o.
GPT-4o mini
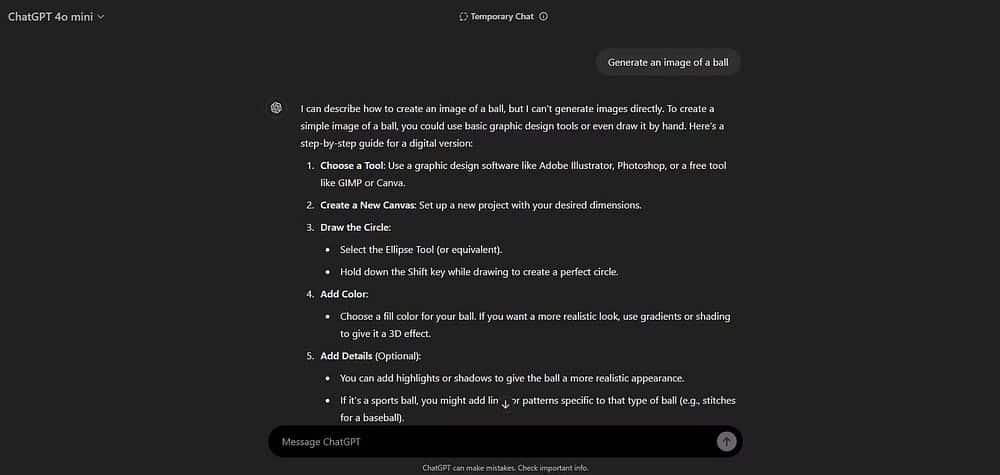
GPT-4o mini ist ein kleines Sprachmodell (SLM), das gut mit vielen großen Sprachmodellen (LLMs) konkurriert. Obwohl es auf kleineren, spezifischeren Datensätzen trainiert wird, übertrifft GPT-4o mini GPT-4 in einigen Schlüsselbereichen, wie z. B. Reaktionsgeschwindigkeit und freiem Benutzerzugriff.
Obwohl GPT-4o mini als Multimedia-Modell konzipiert wurde, unterstützt die aktuelle Version von ChatGPT nur Text, ohne die Möglichkeit, Bilder oder Audio zu verwenden. Darüber hinaus erlaubt ChatGPT für GPT-4o mini im Gegensatz zu GPT-4 und GPT-4o das Anhängen von Dateien nicht. Es ist noch unklar, ob ChatGPT in Zukunft Multimedia-Funktionen in GPT-4o mini ermöglichen wird. verifizieren So können Sie diesen mysteriösen GPT-2-Chatbot noch erleben.
GPT-4o
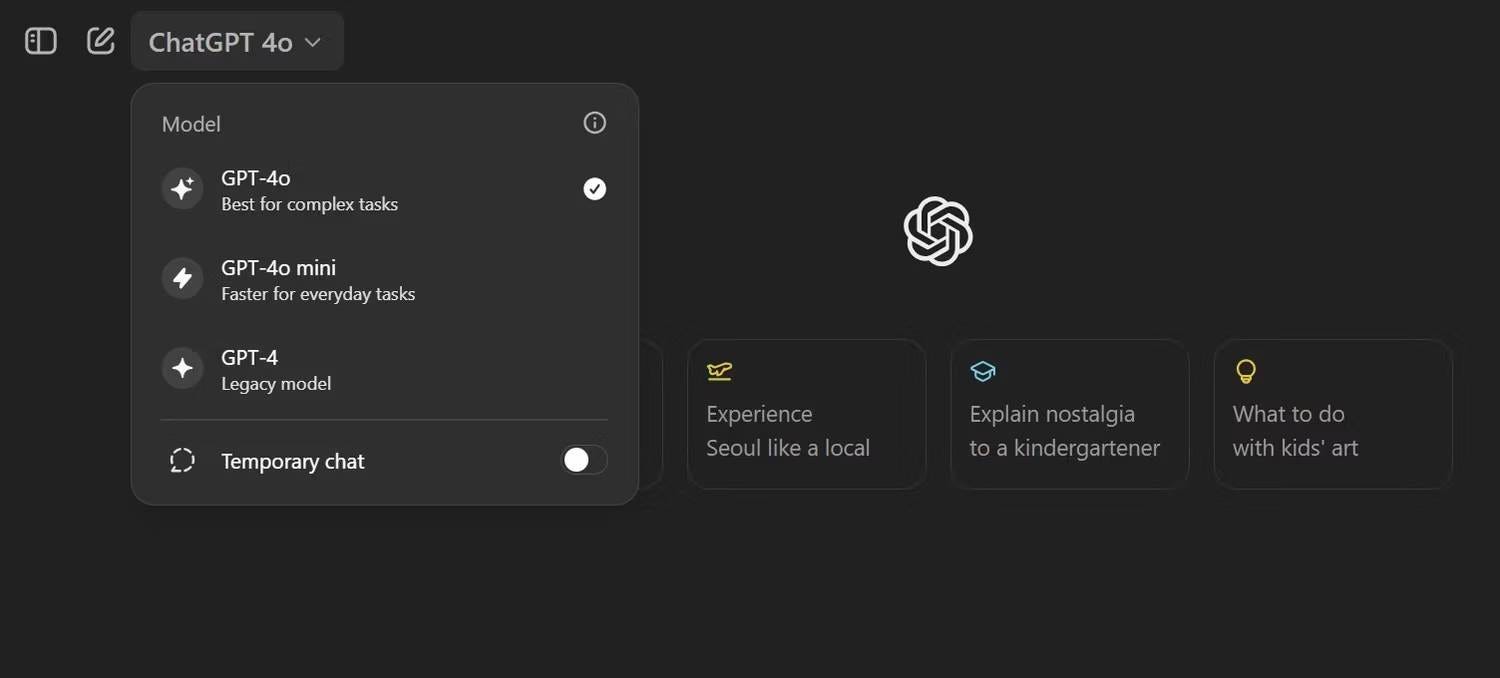
GPT-4o („o“ für „omni“) ist die neueste Ergänzung der GPT-4-Vorlagenserie und die Standardvorlage, die sowohl für ChatGPT-Benutzer in der kostenlosen als auch in der kostenpflichtigen Version ausgewählt wird. Dieses Modell ist viermal intelligenter und schneller als GPT-4 und eignet sich daher ideal für Echtzeitanwendungen. GPT-4o war das erste Multimedia-Modell der Serie, das alle Arten von Dateiformaten wie Text, Audio, Bilder und Videos analysieren und Texte und Bilder innerhalb von ChatGPT generieren konnte.



Darüber hinaus gewährte OpenAI Benutzern des kostenlosen Kontingents eingeschränkten Zugriff auf GPT-4o, mit einer Rate von 16 Nachrichten alle 3 Stunden. Danach wird ChatGPT wieder GPT-3.5 verwenden.
Nachfolgend finden Sie eine Aufschlüsselung der einzelnen GPT-4-Modelle:
| Merkmale | GPT-4 | GPT-4o | GPT-4o mini |
|---|---|---|---|
| Kosten (ChatGPT) | 20 | Kostenlos (16 Nachrichten alle 3 Stunden), 20 $ (80 Nachrichten alle 3 Stunden) | Kostenlos (16 Nachrichten alle 3 Stunden), 20 $ (80 Nachrichten alle 3 Stunden) |
| Empfänglichkeit | Standard | Viermal schnellere Reaktion als GPT-4 | 4x schnellere Reaktion als GPT-XNUMXo |
| Kontextfenster | Bis zu 32 Token | Bis zu 32 Token | Bis zu 32 Symbole |
| Multimedia-Ein-/Ausgabe | لا | نعم | نعم |
| MMLU (Modell der Fähigkeit, Sprache zu verstehen) | 86.3 | 88.7 | 82.0 |
| GPTQA (Fähigkeit des Modells, offene Fragen zu beantworten) | 48.0 | 53.6 | 40.2 |
| MATH (Modellfähigkeit zur Lösung mathematischer Probleme) | 42.5 | 76.6 | 70.2 |
| HumanEval (Bewertung der Modellfähigkeiten in der Programmierung) | 67.0 | 90.2 | 87.2 |
Zusätzlich zu den Kosten, Reaktionszeiten und dem Kontextfenster habe ich jedem Modell auch ein Genauigkeitskriterium hinzugefügt, um den Vergleich der Genauigkeit bei verschiedenen Aufgaben zu erleichtern. Zu den Benchmark-Tests gehören MMLU zum Testen akademischer Kenntnisse, GPQA zur Bewertung des Allgemeinwissens, HumanEval zur Bewertung der Programmierfähigkeit eines Modells und MATH zur Lösung mathematischer Probleme. In jedem Fall ist die höhere Punktzahl besser.
Diese Kriterien helfen dabei, die Leistung des Modells bei verschiedenen Sprachaufgaben im Zusammenhang mit Verständnis, Beantwortung von Fragen, Mathematik und Programmierung zu bestimmen.
- MMLU (Massive Multitask Language Understanding):
MMLU ist ein Benchmark, mit dem die Fähigkeit eines Modells gemessen wird, Sprache bei einer Vielzahl von Aufgaben zu verstehen. Es umfasst Tests, die verschiedene Bereiche wie Mathematik, Naturwissenschaften, Geschichte und andere abdecken, sodass das Modell im Hinblick auf den Umgang mit multidisziplinären Informationen evaluiert werden kann. - GPTQA (GPT-Fragenbeantwortung):
GPTQA bezieht sich auf die Fähigkeit des Modells, offene Fragen zu beantworten, die eine Analyse und Begründung erfordern. Das Modell wird anhand seiner Genauigkeit und Geschwindigkeit bei der Bereitstellung korrekter und umfassender Antworten auf die gestellten Fragen bewertet. - MATHE:
MATH ist ein Standard zur Messung der Fähigkeiten eines Modells bei der Lösung mathematischer Probleme. Das Modell wird anhand verschiedener mathematischer Probleme auf unterschiedlichen Niveaus wie Arithmetik, Algebra und Geometrie getestet, um festzustellen, wie genau es ist und wie gut es mathematische Konzepte versteht. - HumanEval:
HumanEval ist ein Benchmark zur Bewertung der Fähigkeiten von Modellen in der Programmierung. Bei diesem Test wird das Modell mit Programmierproblemen konfrontiert und es muss korrekte Programmierlösungen in einer bestimmten Sprache schreiben. Ein Modell wird anhand der Qualität und Genauigkeit des von ihm erzeugten Codes sowie anhand der Frage bewertet, wie gut es das Problem versteht und löst, ähnlich wie es ein menschlicher Programmierer tut.
Welches GPT-4-Modell sollten Sie verwenden?
Die Wahl des richtigen Modells hängt von Ihren spezifischen Anforderungen und der Art der Aufgaben ab, die Sie ausführen möchten.
GPT-4o ist das leistungsstärkste Modell der Gruppe. Es weist bei allen Standardtests die höchsten Genauigkeitswerte auf und schneidet wahrscheinlich bei jeder Interaktion am besten ab. Allerdings ist die Anzahl der Nachrichten, die Sie an GPT-4o senden können, begrenzt, insbesondere für Benutzer des kostenlosen Kontingents. Diese Einschränkung ist der Hauptgrund, warum Sie ein Upgrade auf ChatGPT Plus durchführen sollten.
Der Einsatz von GPT-4o ist jedoch am besten für Interaktionen reserviert, die eine Multimedia-Ein- und -Ausgabe erfordern oder wenn höchste Präzision erforderlich ist. Da GPT-4o mini in Bezug auf Mathematik, akademische Kenntnisse, Programmierung und Allgemeinwissen eine bessere Leistung als GPT-4 erbringt, sollte dieses Modell für Textabfragen verwendet werden, bei denen eine höhere Genauigkeit erforderlich ist. Verwenden Sie das GPT-4-Formular in Fällen, in denen Dateien wie Dokumente, PDFs und Audiodateien angehängt werden müssen. Sie können es jetzt ansehen ChatGPT Plus vs. Perplexity: Welcher ist der beste KI-Chatbot?