Die meisten der heute verwendeten KI-Tools laufen im Cloud-Computing, was bedeutet, dass sie eine ständige Internetverbindung benötigen. Zwar gibt es Möglichkeiten, KI-Tools lokal auf unseren Geräten auszuführen, doch die allgemeine Meinung ist, dass hierfür leistungsstarke und teure Hardware erforderlich ist.
Das dachte ich auch, bis ich beschloss, einige der nativen KI-Tools auf einer relativ alten Maschine zu testen – einer GTX 1070-Grafikkarte, die es schon seit fast einem Jahrzehnt gibt – und feststellte, dass es tatsächlich möglich und effektiv ist. Dieses Experiment eröffnete neue Möglichkeiten für den Einsatz von KI selbst auf Geräten mit bescheidenen Spezifikationen und machte diese Technologie einem breiteren Nutzerkreis zugänglich.

Schnelle Links
Warum müssen Sie einen lokalen KI-Chatbot verwenden?
Ich habe unzählige KI-gestützte Chatbots online verwendet, wie zum Beispiel ChatGPT, Gemini, Claude und andere. Sie funktionieren hervorragend. Aber was ist, wenn Sie keine Internetverbindung haben und trotzdem einen KI-Chatbot nutzen möchten? Oder wenn Sie an etwas sehr Privatem arbeiten oder Informationen weitergeben möchten, die aus beruflichen oder anderen Gründen nicht preisgegeben werden dürfen?
Dann benötigen Sie ein lokales, Offline-Large Language Model (LLM), das alle Ihre Konversationen und Daten auf Ihrem Gerät speichert. Mit Lokaler KI-Chatbot Nutzen Sie die Leistungsfähigkeit künstlicher Intelligenz, ohne auf eine Internetverbindung angewiesen zu sein.
Datenschutz wird berücksichtigt Einer der Hauptgründe für die Verwendung eines großen lokalen Sprachmodells istAber es gibt auch andere Gründe, wie die Vermeidung von Zensur, Offline-Nutzung, Kosteneinsparungen, Anpassung usw. Es bietet Ihnen Lokaler KI-Chatbot Vollständige Kontrolle über Ihre Daten, um sicherzustellen, dass Ihre vertraulichen Informationen sicher und geschützt bleiben.
Was sind quantisierte große Sprachmodelle (Quantisierte LLMs)?
Die Hardware stellt für die meisten Anwender, die große Sprachmodelle (LLMs) vor Ort nutzen möchten, die größte Herausforderung dar. Die leistungsstärksten KI-Modelle erfordern leistungsstarke Hardware, um sie auszuführen. Neben der Benutzerfreundlichkeit sind Hardwarebeschränkungen ein weiterer Grund, warum die meisten KI-basierten Chatbots auf Cloud Computing basieren.
Hardwarebeschränkungen sind einer der Gründe, warum ich dachte, ich könnte ein großes Sprachmodell (LLM) nicht nativ ausführen. Ich habe derzeit einen recht bescheidenen PC mit einem AMD Ryzen 5800x Prozessor (Markteinführung 2020), 32 GB DDR4 RAM und einer GTX 1070 GPU (Markteinführung 2016). Es handelt sich also nicht um Spitzenhardware, aber wenn man bedenkt, wie wenig ich heutzutage Spiele spiele (und wenn, dann wähle ich Ältere, weniger ressourcenintensive Indie-Spiele) und die hohen Kosten moderner GPUs, bin ich mit dem, was ich habe, zufrieden.
Es stellt sich jedoch heraus, dass Sie nicht das leistungsstärkste KI-Modell benötigen. Quantisierte große Sprachmodelle (Quantisierte LLMs) Es handelt sich um KI-Modelle, die durch Vereinfachung der von ihnen verwendeten Daten, insbesondere Zahlen mit Dezimalpunkt, kleiner und schneller gemacht wurden.
KI arbeitet typischerweise mit hochpräzisen Zahlen (z. B. 32-Bit-Dezimalzahlen), die viel Speicher und Rechenleistung verbrauchen. Durch Quantisierung werden diese Zahlen auf Zahlen mit geringerer Präzision (z. B. 8-Bit-Ganzzahlen) reduziert, ohne das Verhalten des Modells wesentlich zu verändern. Das bedeutet, dass das Modell schneller läuft, weniger Speicherplatz benötigt und auf kleineren Geräten (z. B. Smartphones oder Peripheriegeräten) ausgeführt werden kann, wenn auch manchmal mit einem leichten Genauigkeitsverlust.



Das bedeutet, dass meine alte Hardware zwar sicherlich Schwierigkeiten hätte, ein so leistungsstarkes großes Sprachmodell (LLM) wie Llama 3.1 mit 205 Milliarden Parametern auszuführen, sie könnte jedoch stattdessen das kleinere 8-Billionen-Quantenmodell ausführen.
Und wann OpenAI angekündigt Für meine ersten vollständig quantisierten, offen gewichteten Inferenzmodelle dachte ich, es wäre an der Zeit zu sehen, wie gut sie auf meiner alten Hardware funktionieren.
Wie verwende ich ein großes Sprachmodell (LLM) lokal mit einer Nvidia GTX 1070-Grafikkarte und LM Studio?
Ich möchte diesen Abschnitt mit der Anmerkung beginnen, dass ich weder ein Experte für lokale Large Language Models (LLMs) noch für die Software bin, mit der ich dieses intelligente Modell auf meinem Rechner ausgeführt habe. Ich beschreibe hier lediglich, wie ich einen intelligenten Chatbot lokal auf meiner GTX 1070-Grafikkarte ausgeführt habe, und bewerte die Effizienz dieser Lösung. Ziel ist es zu zeigen, wie Sie Ihre verfügbare Rechenleistung nutzen können, um fortschrittliche KI-Modelle auszuführen, ohne auf Cloud-Dienste angewiesen zu sein.
LM Studio herunterladen
Um ein großes Sprachmodell (LLM) lokal auszuführen, benötigen Sie spezielle Software. Insbesondere ein Programm LM Studio, ein kostenloses Tool, mit dem Sie LLM-Modelle lokal auf Ihrem Gerät herunterladen und ausführen können. Gehen Sie zur LM Studio-Homepage und wählen Sie Download für [Betriebssystem] (Ich verwende Windows 10.) LM Studio ist eine ideale Plattform für Entwickler und Forscher, die mit verschiedenen großen Sprachmodellen experimentieren und ihre Leistung auf ihren persönlichen Computern bewerten möchten, bevor sie sie bereitstellen.
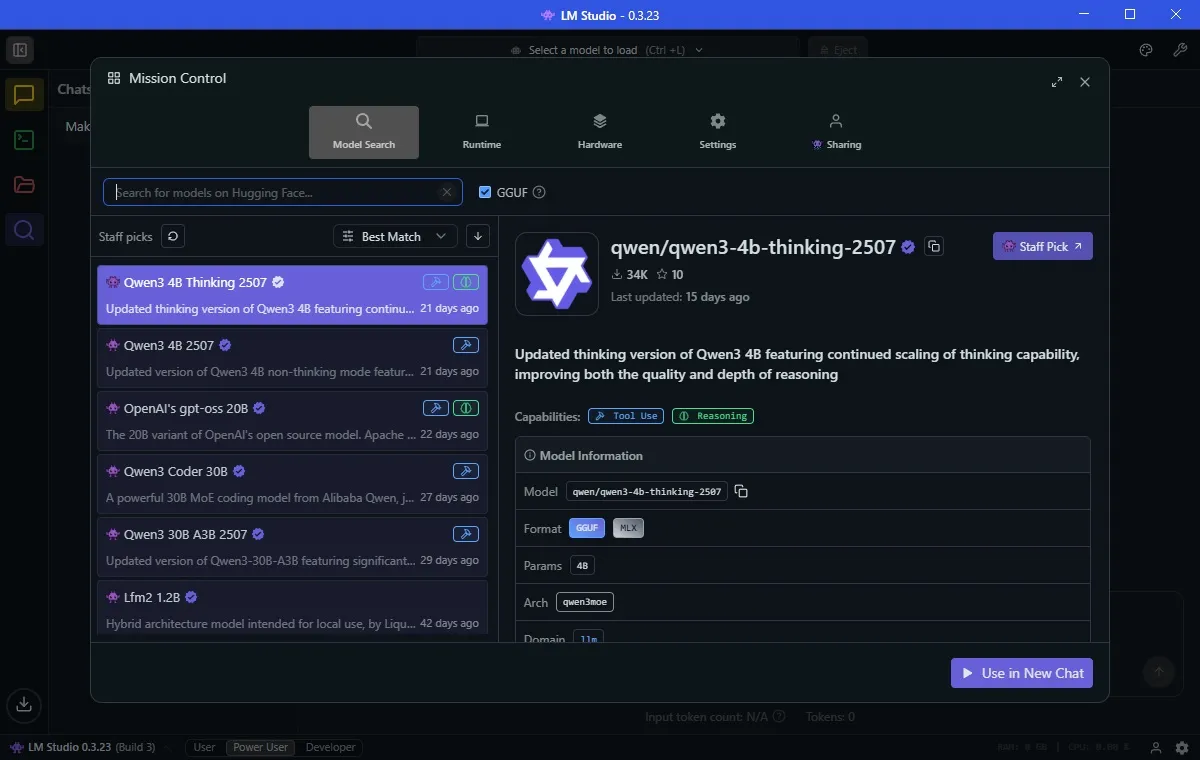
Dies ist ein Standard-Windows-Installationsprozess. Führen Sie das Setup-Programm aus, schließen Sie die Installation ab und starten Sie anschließend LM Studio. Ich empfehle die Auswahl der Power User Weil es einige nützliche Optionen offenbart, die Sie vielleicht erkunden möchten. Diese Option bietet mehr Kontrolle über die Programmeinstellungen und erweiterte Optionen zur individuellen Anpassung der Verwendung von LLM-Modellen. Mit LM Studio können Sie die Welt der großen Sprachmodelle einfach und effizient erkunden.
Laden Sie Ihr erstes lokales KI-Modell herunter
Nach der Installation können Sie Ihr erstes großes Sprachmodell (LLM) laden. Wählen Sie den Reiter Entdecken Sie (Lupensymbol). LM Studio zeigt problemlos die nativen KI-Modelle an, die auf Ihrem Gerät am besten funktionieren.
In meinem Fall schlägt es vor, eine Vorlage mit dem Namen herunterzuladen Qwen 3-4b-Denken-2507Der Modellname ist Qwen (Entwickelt vom chinesischen Technologieriesen Alibaba), die dritte Version dieses Modells. Der Wert „4b“ bedeutet, dass dieses Modell über vier Milliarden Parameter verfügt, um Ihnen zu antworten. „thinking“ bedeutet, dass das Modell Zeit damit verbringt, seine Antwort zu überdenken, bevor es antwortet. 2507 ist der letzte Zeitpunkt der Aktualisierung dieses Modells, nämlich am 25. Juli.
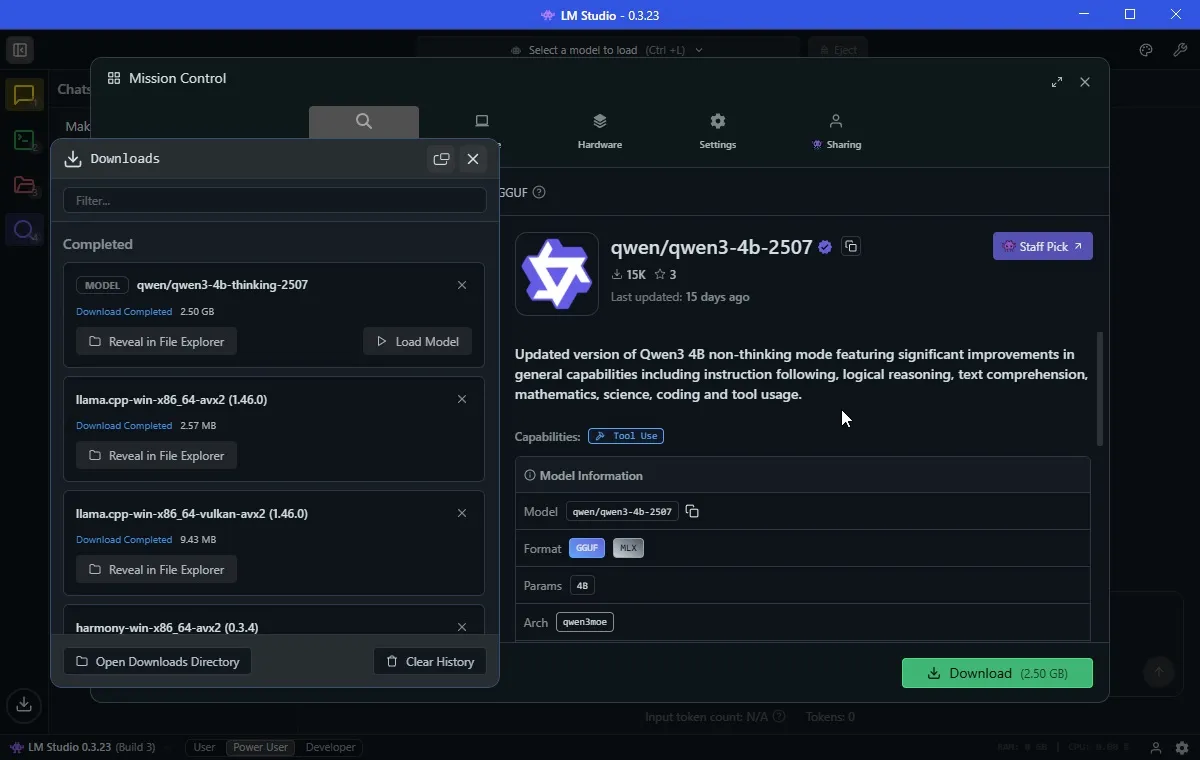
Qwen3-4b-thinking ist nur 2.5 GB groß, daher sollte der Download nicht lange dauern. Ich habe zuvor auch OpenAI/gpt-oss-20b heruntergeladen, das mit 12.11 GB größer ist. Es enthält ebenfalls 20 Milliarden Parameter und sollte daher „bessere“ Antworten liefern, allerdings mit höheren Ressourcenkosten.
Nun, abgesehen von Die Komplexität der Benennung von KI-ModellenSobald Sie LLM heruntergeladen haben, können Sie es fast verwenden.
Bevor Sie das KI-Modell ausführen, gehen Sie zur Registerkarte Hardware Stellen Sie sicher, dass LM Studio Ihr System korrekt identifiziert. Sie können auch nach unten scrollen und anpassen Geländer Hier. Ich habe die Firewalls auf meinem Computer so eingestellt, Ausgewogen, wodurch verhindert wird, dass ein einzelnes KI-Modell zu viele Ressourcen verbraucht, was zu einer Systemüberlastung führen könnte.
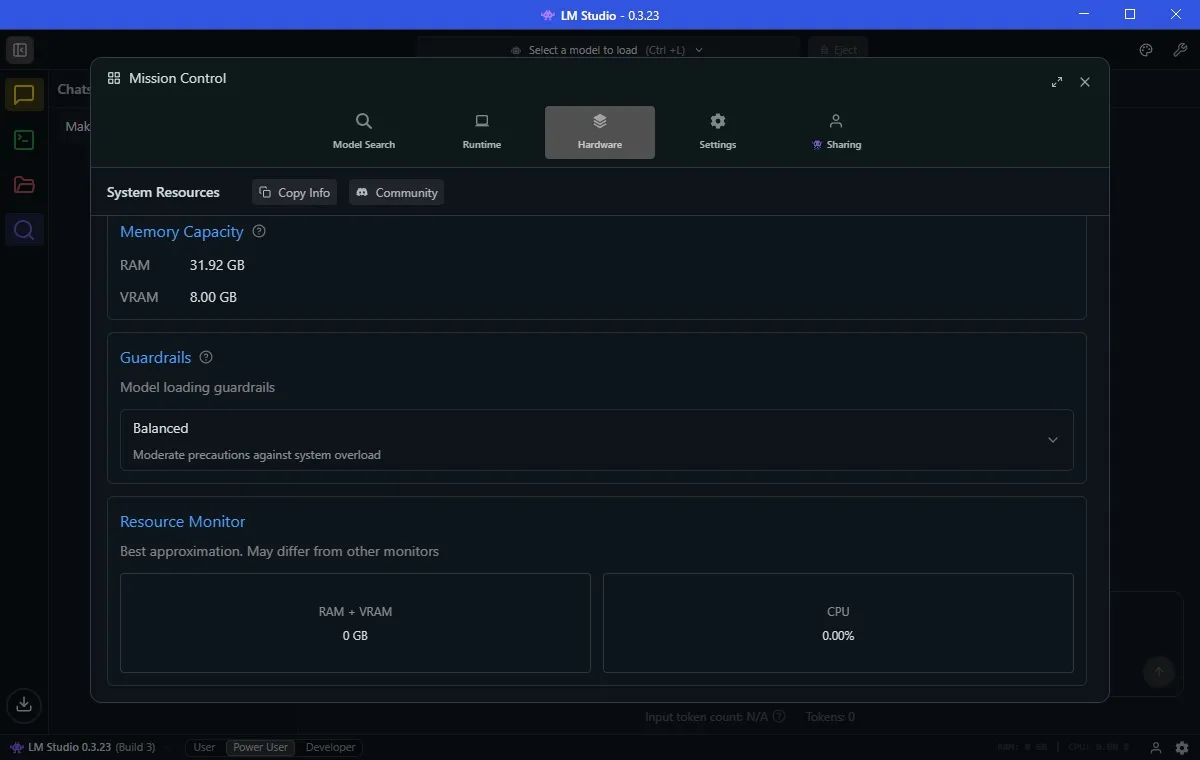
Sie werden auch bemerken Ressourcenmonitor Unter Leitplanken. So können Sie leicht erkennen, wie viel Systemlast Ihr KI-Modell verbraucht. Es lohnt sich, dies zu überwachen, wenn Sie wie ich nur über begrenzte Hardware verfügen, da Sie nicht möchten, dass Ihr System unerwartet abstürzt.
Laden Sie Ihr KI-Modell hoch und beginnen Sie mit der Verwendung.
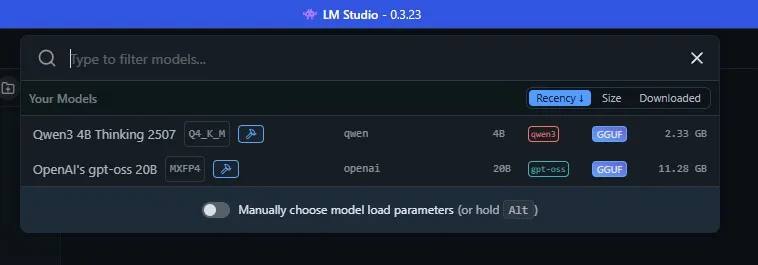
Sie können Ihren KI-Chatbot jetzt lokal auf Ihrem Gerät nutzen. Wählen Sie in LM Studio die obere Leiste, die als Suchfunktion dient. Durch Auswahl des KI-Namens wird das KI-Modell in den Arbeitsspeicher Ihres Computers geladen und Sie können mit der Eingabe von Befehlen und Fragen beginnen. Dieser Vorgang ist notwendig, um die Funktionen des Large Language Model (LLM) direkt auf Ihrem Gerät zu aktivieren. So können Sie KI interaktiv und schnell erleben, ohne ständig mit dem Internet verbunden zu sein. Beachten Sie, dass die Leistung des Modells von den Spezifikationen Ihres Geräts abhängt. Stellen Sie daher sicher, dass Sie über ausreichende Ressourcen verfügen, um Ihr KI-Modell effizient auszuführen.
Lokales Ausführen eines KI-Modells auf älterer Hardware: großartig, aber mit Einschränkungen
Wenn Sie ein KI-Modell lokal ausführen, können Sie die gewohnten Vorteile nutzen. Beachten Sie jedoch einige wichtige Einschränkungen. Diese lokalen Modelle sind zwar nützlich, aber nicht so leistungsstark wie moderne Modelle wie GPT-5, das in ChatGPT verwendet wird. Darüber hinaus werden Sie feststellen, dass der Denk- und Reaktionsprozess deutlich länger dauert und die Qualität der Antworten erheblich variieren kann.
Zur Veranschaulichung habe ich ein klassisches Large Language Model (LLM) sowohl auf Qwen als auch auf gpt-oss getestet. Beide Systeme konnten die Aufgabe erfolgreich abschließen, wenn auch nach langer Wartezeit. Dies zeigt, dass die Verwendung eines nativen KI-Modells auf einem älteren Rechner eine praktische Lösung sein kann, aber Geduld und ein Verständnis für die Einschränkungen älterer Hardware erfordert.
Allen, Bob, Colin, Dave und Emily stehen im Kreis. Allen steht direkt links von Bob. Bob steht direkt links von Colin. Colin steht direkt links von Dave. Dave steht direkt links von Emily. Wer steht direkt rechts von Allen?
Qwen benötigte 5 Minuten und 11 Sekunden, um zur richtigen Schlussfolgerung zu gelangen. GPT-5 benötigte nur etwa 45 Sekunden. Aber wer hat alle übertroffen? gpt-oss-20b mit einer Rekordzeit von 31 Sekunden.
Ein Test reicht nicht aus, also habe ich es mit einem anderen Rätsel versucht, das die Denkfähigkeiten von KI testen soll. In einem früheren Test hatte OpenAIs neuestes Modell, GPT-5, diesen Test nicht bestanden, daher war ich gespannt, wie die Offline-Versionen von Qwen und gpt-oss damit zurechtkommen würden.
Analyse der Leistung von Modellen der künstlichen Intelligenz bei der Lösung logischer Probleme
Die Fähigkeit, logische Probleme zu lösen, stellt für KI-Modelle eine echte Herausforderung dar. Das obige Beispiel, bei dem es um die Identifizierung räumlicher Beziehungen zwischen einer Gruppe von Menschen geht, veranschaulicht, wie unterschiedlich die Leistung dieser Modelle sein kann.
Räumliche Beziehungen und die Herausforderungen der künstlichen Intelligenz
Die Verarbeitung räumlicher Beziehungen ist ein grundlegender Bestandteil künstlicher Intelligenz und erfordert ein ausgeprägtes Sprachverständnis und die Fähigkeit zum logischen Denken. Das vorherige Beispiel zeigt, dass einige Modelle, wie z. B. gpt-oss-20b, diese Aufgabe hervorragend bewältigen, während andere, wie z. B. Qwen und GPT-5, länger brauchen, um zur richtigen Lösung zu gelangen.
Die Bedeutung verschiedener Tests zur Bewertung künstlicher Intelligenz
Kein einzelner Test kann die Fähigkeiten von KI umfassend beurteilen. Es ist notwendig, eine Vielzahl von Tests durchzuführen, die verschiedene Aspekte der Intelligenz abdecken, wie logisches Denken, Sprachverständnis und komplexe Problemlösung. Dies ermöglicht eine genauere Bewertung der Fähigkeiten und Grenzen jedes Modells.
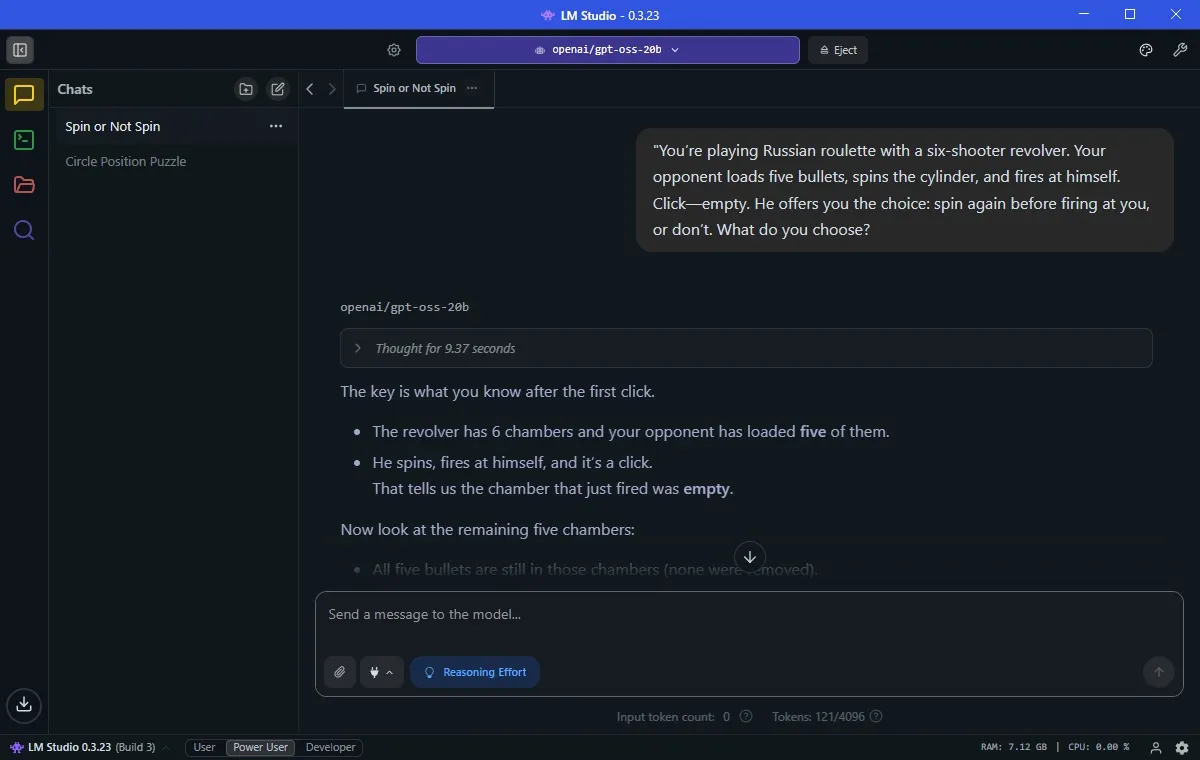
Stellen Sie sich vor, Sie spielen Russisches Roulette mit einer Sechsschusspistole. Ihr Gegner lädt fünf Kugeln, dreht die Trommel und schießt sich dann selbst. „Tick“ bedeutet leer. Anschließend bietet er Ihnen die Wahl: Wollen Sie die Trommel noch einmal drehen, bevor er auf Sie schießt, oder nicht? Wofür entscheiden Sie sich?
Das Qwen-Modell konnte die richtige Antwort in 41 Minute und 5 Sekunden liefern, was angesichts der Hardware-Einschränkungen eine sehr gute Zeit ist. Überraschenderweise konnte GPT-20 dieses Problem jedoch nicht lösen, was wirklich überraschend ist. Es bot mir sogar an, mir ein Diagramm zur Verfügung zu stellen, das die Richtigkeit seiner Antwort zeigte. Auch hier lieferte gpt-oss-9b die richtige Antwort in nur XNUMX Sekunden.
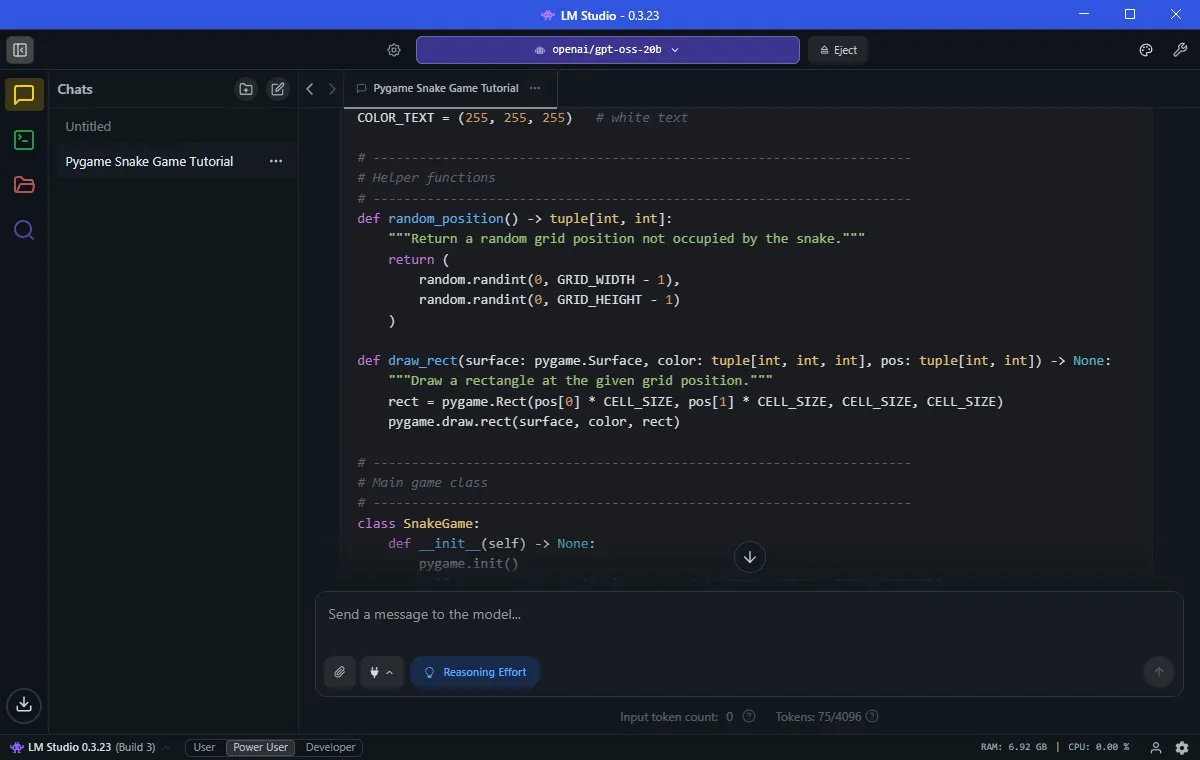
Auch in anderen Bereichen konnte ich sofort Erfolge verzeichnen. Ich bat gpt-oss, mir ein Snake-Spiel mit pygame zu schreiben, und innerhalb von ein bis zwei Minuten hatte ich ein voll funktionsfähiges Snake-Spiel. Dies demonstriert die Fähigkeit des Modells, effizient Spiele zu generieren.
Ausführen eines KI-Modells auf Ihren alten Geräten
Der Schlüssel zum nativen Ausführen eines großen Sprachmodells (LLM) auf älterer Hardware liegt in der Auswahl des richtigen KI-Modells für Ihre Hardwarefunktionen. Während die Qwen-Version eine gute Leistung zeigte und in LM Studio die beste Wahl war, ist das Modell gpt-oss-20b von OpenAI eindeutig die weitaus bessere Wahl.
Es ist jedoch wichtig, die eigenen Erwartungen abzuwägen. Obwohl gpt-oss die Fragen korrekt (und schneller als GPT-5) beantwortete, kann ich ihm keine riesigen Datenmengen zur Verarbeitung zumuten. Die Grenzen meiner Hardware werden schnell deutlich.
Bevor ich es ausprobiert habe, war ich überzeugt, dass es unmöglich sei, einen nativen KI-Chatbot auf meiner älteren Hardware auszuführen. Aber dank Quantenmodellen und Tools wie LM Studio ist es nicht nur möglich, sondern auch überraschend nützlich.
Allerdings erhalten Sie nicht die gleiche Geschwindigkeit, Genauigkeit oder Argumentationstiefe wie mit GPT-5 in der Cloud. Die lokale Ausführung bringt Kompromisse mit sich: Sie gewinnen an Privatsphäre, Offline-Zugriff und Kontrolle über Ihre Daten, verlieren aber etwas an Leistung.
Die Tatsache, dass eine sieben Jahre alte GPU und eine vier Jahre alte CPU überhaupt moderne KI bewältigen können, ist jedoch sehr spannend. Wenn Sie zögern, weil Sie keine High-End-Hardware besitzen, keine Sorge – lokale Quantenmodelle könnten Ihr Weg zur Offline-KI sein. Nutzen Sie das richtige KI-Modell, um das Beste aus Ihrer älteren Hardware herauszuholen.