Es besteht kein Zweifel, dass NVIDIA mit seinen beliebten und vielfältigen Grafikkartenserien weiterhin den Parallel-Computing-Bereich dominiert. Aber mit den Instinct AI-Beschleunigern von AMD, die zwei seiner neuesten und besten Supercomputer (Frontier und El Capitan) antreiben, und der wachsenden Community-Unterstützung für die Open-Source-ROCm-Plattform hat NVIDIA möglicherweise seinen bisher größten Konkurrenten gefunden.
Was genau sind also die KI-Beschleuniger in AMD Instinct? Was macht es leistungsstark und wie schneidet es im Vergleich zu den Tensor-GPUs von NVIDIA ab? Verifizieren Was ist der Unterschied zwischen einem Motherboard mit einem AMD-Prozessor und einem Intel-Prozessor?
Schnelle Links
Was ist AMD Instinct?
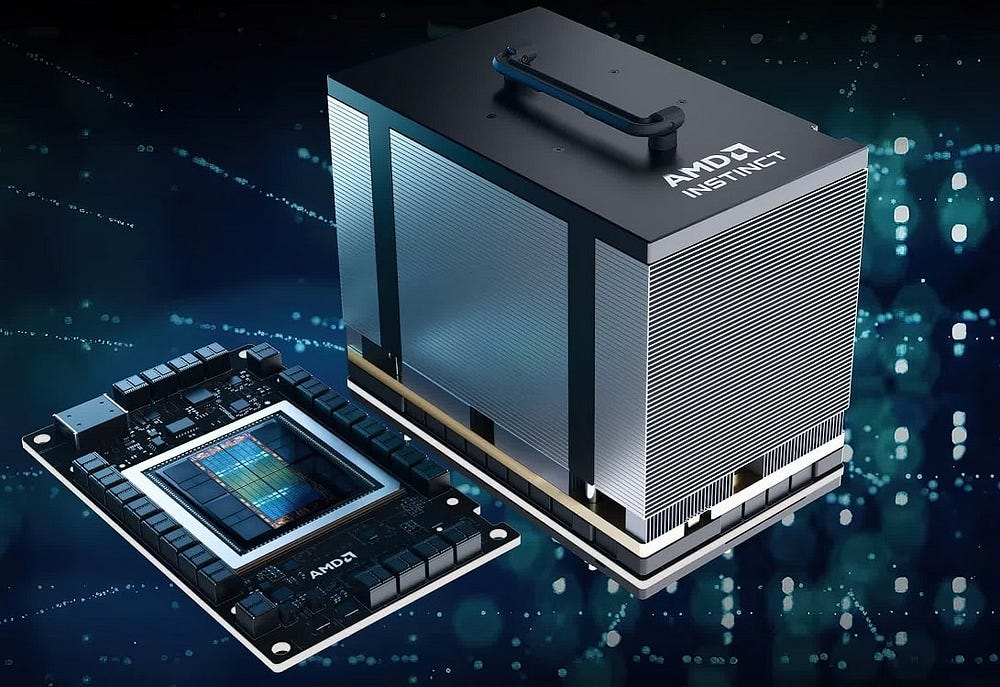
AMD Instinct GPUs sind Unternehmensgeräte, die für High Performance Computing (HPC) und KI-beschleunigte Verarbeitung verwendet werden. Im Gegensatz zu herkömmlichen GPUs für Endverbraucher sind Instinct-GPUs darauf ausgelegt, KI-Lernen, Big-Data-Verarbeitung und andere Hochleistungsaufgaben durch Software- und Hardware-Innovationen besser zu bewältigen.
Die Instinct-Serie von AMD wurde verwendet, um den ersten Supercomputer anzutreiben, der die Exascale-Computing-Grenze durchbrach und mit 1.1 EFLOPs bei Operationen mit doppelter Genauigkeit pro Sekunde lief. Supercomputer mit Instinct-GPUs werden derzeit für die Erforschung von Krebsbehandlungen, nachhaltiger Energie und Klimawandel eingesetzt.
Hochleistungsrechnen (HPC) ist zu einem wesentlichen Bestandteil unserer modernen Welt geworden und führt komplexe Simulationen und Berechnungen durch, die für die wissenschaftliche Forschung, Technik, Sicherheit und andere Bereiche unerlässlich sind. Da jedoch die Nachfrage nach HPC wächst, häufig in Supercomputern und großen Rechenzentren, sind die Bedenken hinsichtlich der Auswirkungen auf die Umwelt gestiegen. In den letzten Jahren wurde der Schwerpunkt zunehmend auf die Nachhaltigkeit von Rechenzentren gelegt, da dies Auswirkungen auf die Gesamtbetriebskosten und Klimabedenken hat.
Wie Instinct-GPUs Intelligenz und Hochleistungsrechnen beschleunigen
Damit die leistungsstärksten Mainframe-Server und Supercomputer der Welt eine Verarbeitung auf Exascale-Niveau erreichen konnten, mussten AMD Instinct-Beschleuniger mit vielen technologischen Verbesserungen und Innovationen ausgestattet werden.
Lassen Sie uns einige der neuen und aktualisierten Technologien besprechen, die in AMD Instinct-GPUs verwendet werden.
1. Technologiearchitektur (CDNA)
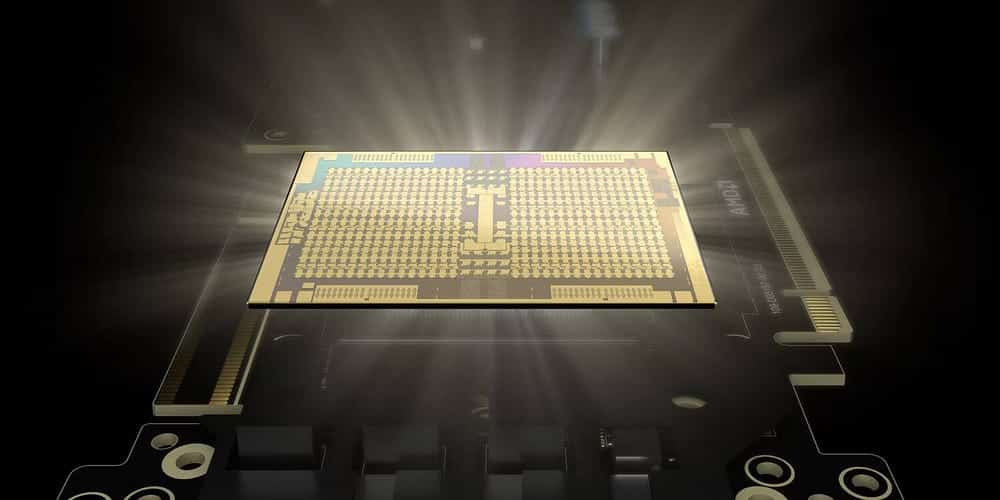
Aktuelle AMD Instinct-Beschleuniger (beginnend mit dem MI100) haben die CDNA-Architektur des Unternehmens verwendet.
CDNA konzentriert sich hauptsächlich auf Funktionen wie Parallelverarbeitung, Speicherhierarchie und verbesserte Rechenleistung durch seine Matrix Core-Technologie. Sogar HPC und KI oder maschinelles Lernen, die auf einzelnen Servern laufen, können von CDNA unterstützt werden, ebenso wie riesige Exascale-Computer.
Die AMD Matrix Core-Technologie beschleunigt das KI-Lernen durch die Unterstützung von Operationen mit gemischter Präzision. Durch die Möglichkeit, mit unterschiedlichen Auflösungen zu rechnen, können Instinct-GPUs Matrixoperationen basierend auf dem erforderlichen Genauigkeitsgrad effizient berechnen.
Zu den gängigsten Berechnungsauflösungsformaten gehören FP64, FP32, FP16, BF16 und INT8. FP steht für Floating Point, BF steht für Brain Floating Point und INT steht für Integer. Je größer die dem Format entsprechende Zahl ist, desto genauer ist die Berechnung. Der Betrieb mit 64-Bit wird als doppelte Präzision bezeichnet. Bei 32 Bit ist die Genauigkeit einfach, bei 16 Bit ist sie halb genau und so weiter.
Da ein großer Teil des Trainings von Deep-Learning-Modellen keine große Präzision erfordert, reduziert die Möglichkeit, Matrixoperationen mit halber oder sogar viertel Genauigkeit für Inferenzen zu berechnen, den Arbeitsaufwand erheblich und beschleunigt so das KI-Lernen. Verifizieren Meine KI von Snapchat oder ChatGPT: Welche sollten Sie verwenden?
2. Speicher mit hoher Bandbreite (HBM)
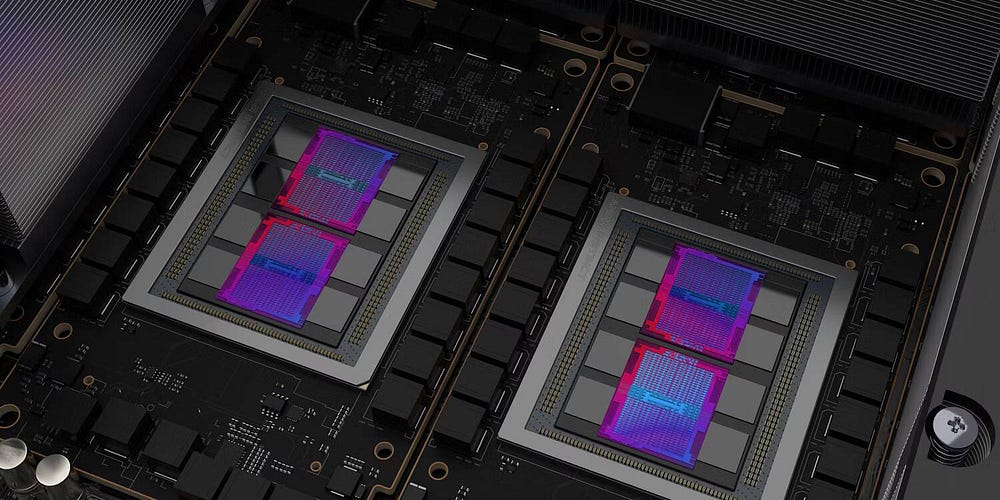
Jeder AMD Instinct-Beschleuniger verfügt über bis zu 880 Matrix-Kerne. Da die Matrix-Core-Prozessoren von AMD 383 TFLOPs halbminütiger Berechnungen ausführen können, ist ultraschneller Speicher unerlässlich. AMDs neuestes Instinct-Angebot verfügt über High Bandwidth Memory (HBM) anstelle des üblichen DDR4- oder DDR5-RAM.
Im Gegensatz zu herkömmlichen Speichern verwendet HBM eine sogenannte dreidimensionale Stapelarchitektur. Diese Architektur beschreibt ein Designkonzept, bei dem DRAM-Module vertikal übereinander gestapelt werden. Dadurch ist das Stapeln von Modulen sowohl in vertikaler als auch in horizontaler Richtung möglich, daher der Begriff „dreidimensionales Stapeln“.
Mithilfe dieser 5D-Stapeltechnologie kann HBM über physische Speicherkapazitäten von bis zu einigen Hundert Gigabyte pro Modul verfügen, während DRRXNUMX nur bis zu einigen zehn Gigabyte pro Modul erreichen kann. Abgesehen von der Kapazität ist bekannt, dass HBM auch eine höhere Leistung hinsichtlich der Übertragungsrate und eine bessere Energieeffizienz als herkömmlicher DDR-Speicher aufweist.
3. Infinity-Stoff
Eine weitere in Instinct-GPUs integrierte Innovation ist die Infinity Fabric-Technologie von AMD. Infinity Fabric ist eine Art Verbindungssystem, das CPUs und GPUs auf dynamische und intelligente Weise verbindet. Dadurch können Komponenten effizient miteinander kommunizieren.
Mit Infinity Fabric werden Komponenten nicht mehr an einen regulären Bus angeschlossen, sondern in einer netzartigen Konfiguration, in der die Bandbreite mehrere hundert Gigabyte pro Sekunde erreichen kann.
Neben der netzwerkähnlichen Verbindung nutzt Infinity Fabric auch in jedes Modell eingebettete Sensoren, um Frequenz, Datenübertragungsraten und andere adaptive Verhaltensweisen dynamisch zu steuern und so die Leistung zu verbessern und die Latenz zu reduzieren.
4. ROCm-Entwicklungsplattform
NVIDIAs CUDA (Unified Computing Device Architecture) ist die am weitesten verbreitete Entwicklungsplattform für das Training von KI-Modellen. Das Problem mit CUDA ist, dass es nur mit NVIDIA-GPUs funktioniert. Dies ist einer der Hauptgründe, warum NVIDIA die überwiegende Mehrheit der Marktanteile bei HPC- und KI-Beschleunigern hält.
Da AMD einen größeren Anteil am HPC- und KI-Markt haben wollte, mussten sie ihre eigene Plattform ROCm (Radeon Open Compute) entwickeln. ROCm ist eine Open-Source-Softwareplattform, die den Einsatz von Instinct-GPUs als KI-Beschleuniger ermöglicht.
Obwohl ROCm nicht unbedingt Teil der Instinct-Hardware ist, ist es der Schlüssel zum Überleben der Instinct-GPU-Reihe. Mit ROCm erhalten Entwickler und Forscher die ROCm-Tools, den Compiler, Kernel-Treiber, einen vollständigen Satz an Bibliotheken und Zugriff auf Frameworks wie TensorFlow und PyTorch, um mit ihrer bevorzugten KI-Programmiersprache zu entwickeln.
Wie schneiden die KI-Beschleuniger von AMD Instinct im Vergleich zu denen in Radeon ab?
AMD bietet die Instinct-Reihe von Enterprise-GPUs und Radeon-Consumer-GPUs an. Wie bereits erwähnt, nutzt der Instinct-Prozessor die CDNA-Architektur von AMD und HBM sowie Infinity Fabric für die Verbindung. Umgekehrt nutzen Radeon-Prozessoren die RDNA-Architektur, DDR6-Speicher und Infinity Cache von AMD.
Obwohl die Radeon-Serie von KI-Beschleunigern weniger leistungsfähig ist, verfügt sie dennoch über einen oder zwei KI-Beschleunigerkerne pro Recheneinheit. Die neueste Radeon RX7900 XT GPU verfügt über zwei KI-Beschleunigerkerne pro Recheneinheit, was 103 TFLOPs mit halber Maximalauflösung und 52 TFLOPs mit Einzelspitzenauflösung ermöglicht.
Während sich die GPUs der Instinct-Serie besser für LLMs und HPCs eignen, können Radeon-KI-Beschleuniger für die Feinabstimmung vorab trainierter Modelle, Inferenzen und grafikintensiver Aufgaben verwendet werden.
Vergleich zwischen AMD Instinct und NVIDIA Tensor
In Bezug auf eine Umfrage Trendforce , NVIDA hat etwa 80 % des Marktanteils bei Server-GPUs, während AMD nur etwa 20 % der restlichen hat. Dieser überwältigende Erfolg von NVIDIA ist darauf zurückzuführen, dass es sich um ein Unternehmen handelt, das sich auf die Entwicklung und Montage von Grafikprozessoren spezialisiert hat. Dies ermöglicht die Entwicklung leistungsstärkerer GPUs, die von anderen Angeboten nicht erreicht werden.
Vergleichen wir den Instinct MI205X von AMD und den H100SXM5 von NVIDIA anhand der Spezifikationen von Offizielle AMD-WebsiteUnd NVIDIA-Datenblatt Ihr eigenes:
| GPU-Typ | FP64 (TFLOPs) | FP32 (TFLOPs) | FP16 (TFLOPs) | INT8 (TFLOPs) |
|---|---|---|---|---|
| AMD Instinct MI250X | 30.0 | 60.0 | 1000 | 2000 |
| NVIDIA H100SXMS | 47.9 | 95.7 | 383.2 | 383 |
Wie aus der Tabelle hervorgeht, schneidet der MI250X von AMD bei Berechnungen mit doppelter und halber Genauigkeit besser ab, während der H100SXMS von NVIDIA bei Matrixberechnungen mit halber und viertel Genauigkeit deutlich besser abschneidet. Dadurch eignet sich AMDs MI250X besser für HPC, während NVIDIAs H100SXMS mit KI-Lernen und Argumentieren ausgestattet ist. Verifizieren Vergleich von AMD- und NVIDIA-Grafikkarten unter Linux: Welche sollten Sie verwenden?
AMD Instinct-Prozessorempfänger
Obwohl AMDs neuestes Angebot, der MI250X, für HPC konzipiert ist, ist der kommende MI300 eher auf KI-Training ausgerichtet. Dieser KI-Beschleuniger soll eine APU sein, die eine GPU und eine CPU in einem einzigen Paket vereint. Dadurch kann die MI300-GPU die CNDA3 Unified Memory APU-Architektur nutzen, bei der GPU und CPU nur einen Speicher nutzen, was die Effizienz erhöht und den Preis senkt.
Obwohl AMD heute nicht mit NVIDIA auf dem Markt für KI-Beschleuniger konkurrieren wird, könnte die Instinct-Serie von AMD nach der Veröffentlichung des MI300 und der Verbesserung von ROCm gut genug sein, um NVIDIA einen erheblichen Teil des Marktes für KI-Beschleuniger zu entreißen. Sie können es jetzt ansehen Was ist der Unterschied zwischen Nvidia GTX und Nvidia RTX?