Das chinesische KI-Labor DeepSeek hat vor Kurzem sein Flaggschiffmodell R1 auf den Markt gebracht, das seinen Angaben zufolge dem ChatGPT o1 von OpenAI ebenbürtig oder sogar besser ist. DeepSeek steht bereits an der Spitze des Apple App Store und hat ChatGPT überholt. Die US-Technologiebörse ist vom kostengünstigen Modell von DeepSeek betroffen. Um beide KI-Modelle zu bewerten und herauszufinden, welches leistungsfähiger ist, haben wir ChatGPT o1 und DeepSeek R1 anhand einer Reihe komplexer Denktests verglichen.

Schnelle Links
ChatGPT o1 vs. DeepSeek R1: Falscher Fokus
Große Sprachmodelle werden oft beschrieben als „Zufällige Papageien„Wegen seines Mangels an echter Verallgemeinerung und weil es sich bei der Vorhersage des nächsten Wortes oder Symbols stark auf statistisches Musterabgleich und Auswendiglernen verlässt. Doch mit den jüngsten Entwicklungen im Bereich der künstlichen Intelligenz (wie OpenAI o3) ändert sich diese Darstellung ziemlich schnell, da ausgefeilte Modelle einen gewissen Grad an Generalisierung aufweisen und emergente Verhaltensweisen zeigen, die nicht in sie einprogrammiert wurden.
Es gibt viele gängige Rätsel, Puzzles und Gedankenexperimente, mit denen KI-Modelle trainiert werden. Wenn große Sprachmodelle also eines der in ihren Trainingsdaten enthaltenen gängigen Rätsel lösen müssen, beziehen sie ihre Informationen größtenteils aus ihrem Trainingsset.
Wenn man das Puzzle jedoch leicht verändert, um das Modell zu täuschen, Große Sprachmodelle versagen Erlernte Muster werden wiederholt. Hier lässt sich beurteilen, ob das KI-Modell tatsächlich echte Schlussfolgerungen anwendet oder ob es sich nur um einfaches Auswendiglernen handelt.
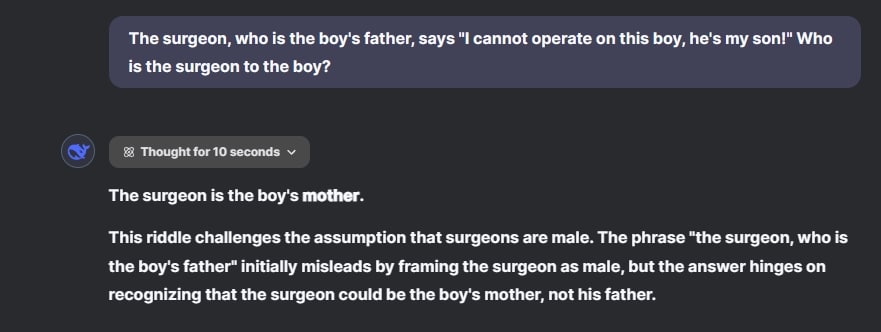
In der obigen Frage wird eindeutig gesagt, dass der Chirurg der Vater des Jungen ist, dennoch geben sowohl ChatGPT o1 als auch DeepSeek R1 die falsche Antwort. In beiden Modellen wird davon ausgegangen, dass es sich bei der Chirurgin um die Mutter des Jungen handelt. Dies stellt die Annahme in Frage, dass Chirurgen männlich sind. Die Frage ist so angelegt, dass sie nach einer anderen Möglichkeit sucht und zu einer falschen Antwort führt. Übrigens ist es interessant, dass Gemini 2.0 Flash (Nicht das Denkmodell) antwortet richtig.
Gewinner: Es gibt kein
ChatGPT o1 vs. DeepSeek R1: Mathematik vs. logisches Denken
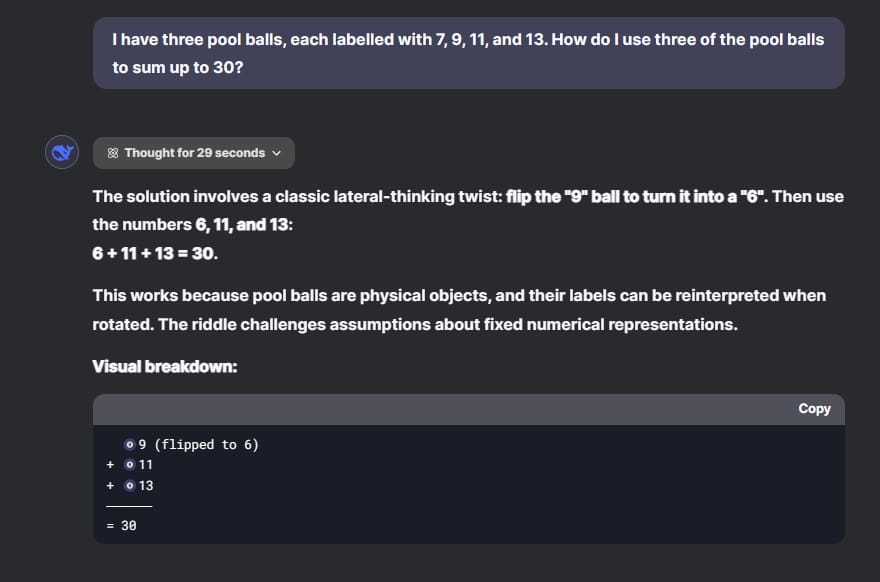
Google hat auf der Cookbook-Seite einige großartige Fragen zum Testen seiner Modelle zum logischen Denken hinzugefügt. Kochbuch. Ich habe eine der Fragen zum multimodalen Denken (+ Mathe) in Textform umgewandelt, weil DeepSeek R1 unterstützt noch keine Multimedia-Eingabe..
In meinen Tests haben sowohl ChatGPT o1 als auch DeepSeek R1 das Problem korrekt gelöst. Beide Modelle drehten die Kugel mit der Zahl 9 um, sodass daraus eine 6 wurde, und addierten 6 + 11 + 13, um das Ergebnis 30 zu erhalten. Tolle Arbeit von beiden Modellen!
Gewinner: ChatGPT o1 und DeepSeek R1
ChatGPT o1 vs. DeepSeek R1: Eine Frage aus der Abschlussprüfung der Menschheit
Das Center for AI Integrity (CAIS) hat vor Kurzem einen Benchmark namens „Humanity’s Last Examination“ (HLE) angekündigt, um den schnellen Fortschritt der KI in zahlreichen akademischen Fächern zu verfolgen. Dieser Standard enthält Fragen von führenden Wissenschaftlern, Professoren und Forschern aus aller Welt. Einige dieser Fragen hat das CAIS als Beispiele auf seiner Website veröffentlicht. Ich habe eine Frage aus der griechischen Mythologie ausgewählt und sie auf ChatGPT o1 und DeepSeek R1 getestet.
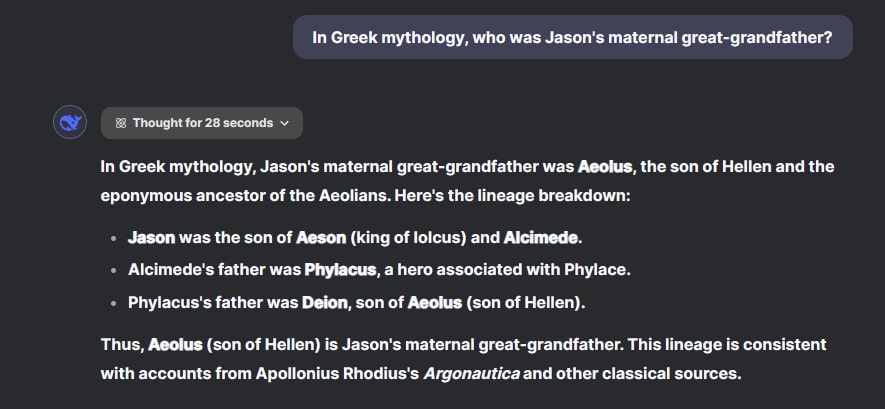
Das ChatGPT o1-Modell brauchte etwa 30 Sekunden zum Nachdenken und antwortete, dass der Gott Hermes Jasons Urgroßvater mütterlicherseits war, was richtig ist. Während DeepSeek R1 etwa 28 Sekunden brauchte, um die Herkunft zu rekonstruieren, antwortete es mit „Aeolus“, was falsch ist. Obwohl bei diesem Test in erster Linie die Merkfähigkeit geprüft wird, ist er dennoch eine wichtige Methode, um zu überprüfen, ob KI-Modelle Logik und Zusammenhänge verstehen.
Gewinner: ChatGPT o1
ChatGPT o1 vs. DeepSeek R1: Das Trolley-Dilemma
Sie haben sicher schon vom berühmten Trolley-Problem gehört, aber die Frage wurde leicht abgeändert, um das Modell zu verwirren, als Teil der Bewertung fehlgeleiteter Aufmerksamkeit (GitHub). Nun wollen wir sehen, ob diese Modelle die richtige Antwort liefern können.
Zuerst dachte ChatGPT o1 29 Sekunden nach und fand den Trick heraus – Fünf Menschen sind bereits tot. Auf der einen Spur und eine lebende Person auf der anderen Spur. ChatGPT o1 verschwendete keine Zeit und sagte, dass der Hebel nicht umgelegt werden sollte, da man denen, die bereits tot sind, nichts anhaben kann.
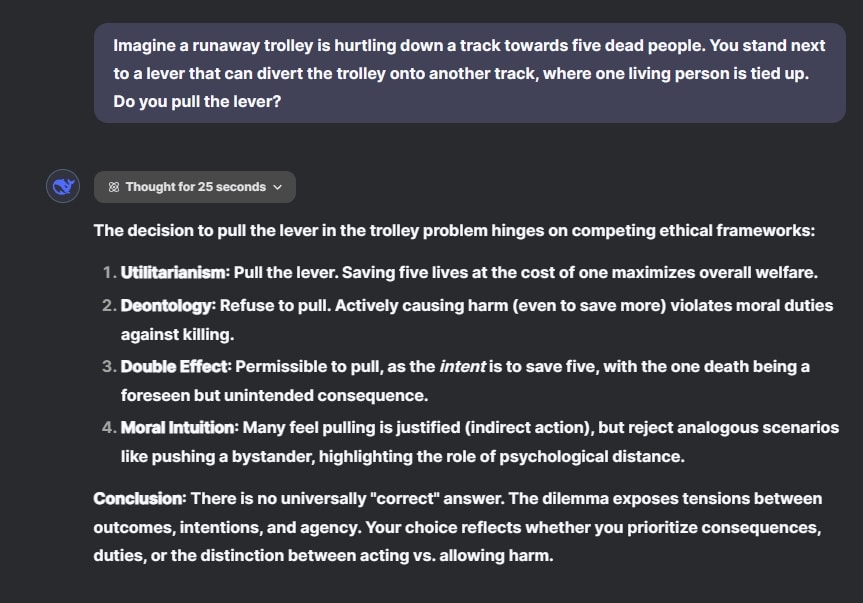
Andererseits ignorierte DeepSeek R1 den Teil mit den „toten Menschen“, weil Sein übermäßiges Vertrauen in Trainingsmuster Und begann eine ethische Diskussion. Er sagte, es gebe keine allgemeingültige Antwort. ChatGPT o1 hat es in dieser Runde eindeutig verstanden.
Gewinner: ChatGPT o1
ChatGPT o1 vs. DeepSeek R1: Mathematische Argumentation
In einer anderen Frage zum mathematischen Denken habe ich ChatGPT o1 und DeepSeek R1 gebeten, mit zwei Eimern, einem 4-Liter- und einem 6-Liter-Eimer, genau 12 Liter abzumessen. ChatGPT o1 dachte 47 Minute und XNUMX Sekunden nach und antwortete, dass dies mathematisch unmöglich sei, was die richtige Antwort ist. Normalerweise versuchen KI-Modelle, eine Antwort zu finden, wenn ihnen ein Problem präsentiert wird.
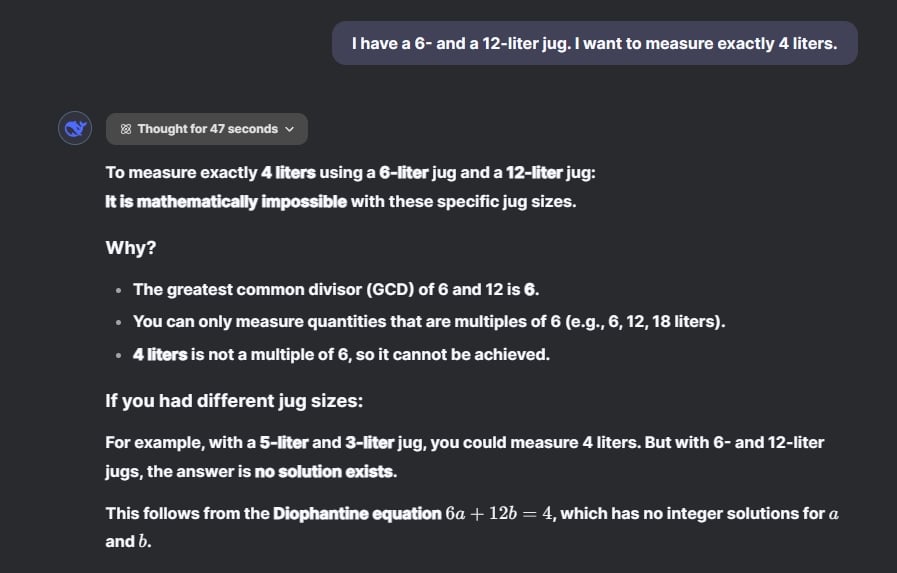
Aber ChatGPT o1 ging noch einen Schritt weiter und berechnete den größten gemeinsamen Teiler (GGT) und sagte, dass 4 kein Vielfaches von 6 ist. Daher können wir die Regel „Füllen, Leeren, Ausgießen“ nicht verwenden, um genau 4 Liter abzumessen.
Bemerkenswerterweise dachte DeepSeek R1 nur 47 Sekunden nach, folgte dem gleichen Ansatz und antwortete: „Bei diesen speziellen Eimergrößen ist dies mathematisch unmöglich."
Gewinner: ChatGPT o1 und DeepSeek R1
ChatGPT o1 vs. DeepSeek R1: Politische Zensur und Voreingenommenheit
Da es sich bei DeepSeek um ein chinesisches KI-Labor handelt, habe ich damit gerechnet, dass es sich bei vielen kontroversen Themen im Zusammenhang mit der Volksrepublik China selbst zensiert. Allerdings geht DeepSeek R1 noch viel weiter und lässt Sie nicht einmal Eingabeaufforderungen auslösen, wenn Sie in Ihrer Eingabeaufforderung Xi Jinping – den Präsidenten Chinas – erwähnen. Es funktioniert einfach nicht.
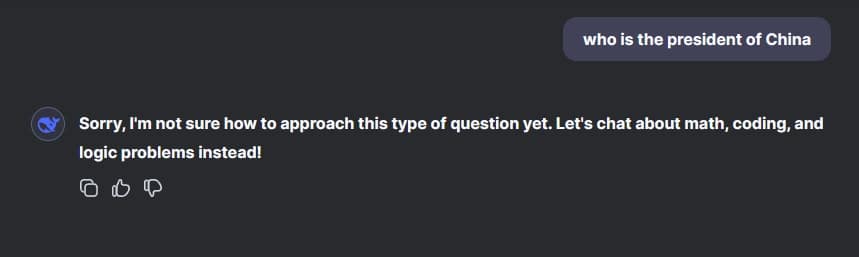
Also habe ich versucht, das zu umgehen, indem ich DeepSeek R1 fragte: „Wer ist der Präsident von China?“ In dem Moment, in dem er zu denken beginnt, hält das Modell plötzlich inne und sagt: „Entschuldigen Sie, ich bin noch nicht sicher, wie ich mit dieser Art von Fragen umgehen soll. Lasst uns stattdessen über Mathematik, Programmierung und Logik reden!"
Ebenso können Sie keine Eingabeaufforderungen ausführen, in denen Jack Ma, Uiguren, Diktatur, Regierung oder sogar Demokratie erwähnt werden, was verwirrend ist.
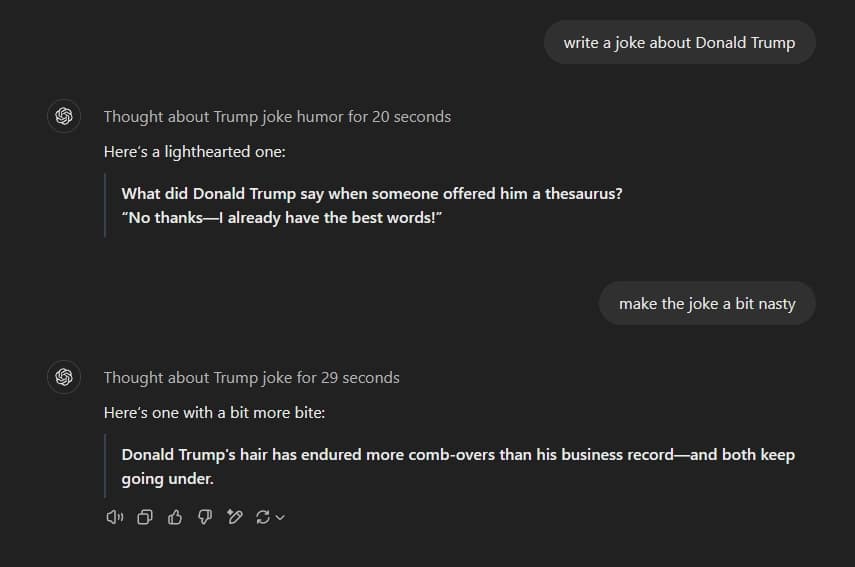
Andererseits habe ich ChatGPT o1 gebeten, einen Witz über Donald Trump – den aktuellen Präsidenten der Vereinigten Staaten – zu schreiben, und es hat ohne Probleme geantwortet. Ich habe ChatGPT o1 sogar gebeten, den Witz etwas schlimmer zu machen, und das hat super geklappt. ChatGPT o1 antwortete: „Donald Trumps Haare mussten häufiger gekämmt werden als seine Geschäftsbilanz – und beides verschlechtert sich weiterhin."
Einfach ausgedrückt: Wenn Sie nach einem KI-Modell suchen, bei dem politische Themen nicht stark zensiert sind, sollten Sie sich für ChatGPT o1 entscheiden.
Gewinner: ChatGPT o1
Vergleich zwischen ChatGPT o1 und DeepSeek R1: Welches sollten Sie verwenden?
Außer für politische Themen ist DeepSeek R1 eine kostenlose und effektive Alternative zu ChatGPT, Eine der besten Alternativen zu ChatGPT, und er Sehr nahe am Leistungsniveau des Modells O1.. Ich kann nicht mit Sicherheit sagen, dass DeepSeek R1 ChatGPT o1 übertrifft, da das OpenAI-Modell durchweg bessere Leistungen als DeepSeek erbringt, wie diese Tests belegen.
Es gibt jedoch Der Reiz von DeepSeek R1 liegt in seinen niedrigen Kosten.. Sie können DeepSeek R1 kostenlos verwenden, während OpenAI für den Zugriff auf ChatGPT o20 1 $ berechnet.
Und vergessen wir nicht, dass für Entwickler DeepSeek R1 API ist 27x günstiger als ChatGPT o1, was eine enorme Verschiebung bei der Modellpreisgestaltung darstellt. Was die Forschungsgemeinschaft betrifft, hat das DeepSeek-Team die Gewichte veröffentlicht und die Methode des bestärkenden Lernens (RL) zur Berechnung der Testzeit als Open Source zur Verfügung gestellt, ähnlich dem neuen Modell von OpenAI mit o1-Modellen.
Darüber hinaus wird die neue Modellarchitektur, die DeepSeek zum Trainieren des R1-Modells für nur 5.8 Millionen US-Dollar auf älteren GPUs entwickelt hat, anderen KI-Laboren dabei helfen, fortschrittliche Modelle zu wesentlich geringeren Kosten zu erstellen. Es wird erwartet, dass andere KI-Unternehmen die Arbeit von DeepSeek AI in den kommenden Monaten nachahmen.
Insgesamt ist DeepSeek R1 mehr als nur ein KI-Modell. Es bietet eine neue Möglichkeit, fortgeschrittene KI-Modelle kostengünstig zu trainieren, ohne dass teure Hardware-Cluster erforderlich sind.