Zusammenfassung:
- Wenn Sie Bedenken hinsichtlich des Datenschutzes haben, können Sie das DeepSeek R1-Modell lokal auf Ihrem Windows-, macOS-, Android- oder iOS-Computer ausführen.
- Sie können LM Studio installieren, um das speziell destillierte Modell DeepSeek R1 7B auszuführen, aber Ihr Gerät muss über 8 GB RAM verfügen.
- Andernfalls können Sie Ollama installieren und mit den destillierten Modellen von DeepSeek R1 beginnen. Es bietet sogar ein kleines Modell mit 1.5 Milliarden Parametern.
- Sie können DeepSeek R1 nativ auf Android und iOS mit der kostenlosen PocketPal AI-App ausführen.
Das Modell DeepSeek R1 eines chinesischen Teams hat in der KI-Branche für Aufsehen gesorgt. Es hat ChatGPT übertroffen und steht an der Spitze der US-App-Store-Liste. Darüber hinaus hat DeepSeek den US-Technologiemarkt mit seinem Vorzeigemodell R1 aufgemischt, das eigenen Angaben zufolge auf Augenhöhe mit ChatGPT steht. Obwohl Sie auf der offiziellen Website von DeepSeek R1 kostenlos auf diesen zugreifen können, haben viele Benutzer Datenschutzbedenken, da die Daten in China gespeichert werden. Wenn Sie DeepSeek R1 lokal auf Ihrem PC oder macOS ausführen möchten, können Sie dies ganz einfach mit LM Studio und Ollama tun. Hier finden Sie eine Schritt-für-Schritt-Anleitung für den Einstieg.

Schnelle Links
Lokale Betriebsanforderungen für DeepSeek R1
Um das DeepSeek R1-Modell nativ auf einem PC, macOS- oder Linux-System auszuführen, muss Ihr Gerät über mindestens 8 GB RAM verfügen. Mit 8 GB Speicher können Sie das kleine DeepSeek R1-Modell mit 1.5 Milliarden Parametern recht effizient ausführen und Ausgaben mit etwa 13 Symbolen pro Sekunde liefern. Sie können auch ein Modell mit 7 Milliarden Parametern ausführen, dies verbraucht jedoch etwa 4 GB Speicher, wodurch Ihr System möglicherweise etwas langsamer reagiert.
Wenn mehr Speicher verfügbar ist, können Sie auch Modelle mit 14 Milliarden, 32 Milliarden und 70 Milliarden Parametern ausführen, aber Sie benötigen eine schnellere CPU und GPU. Derzeit verwendet die meiste Software keine Neural Processing Unit (NPU), um native KI-Modelle auszuführen. Stattdessen basiert es hauptsächlich auf der CPU und in einigen Fällen (wie etwa bei High-End-GPUs von Nvidia) wird die GPU auch für Inferenzen verwendet.
Für Android-Telefone und iPhones werden mindestens 6 GB RAM empfohlen, um das DeepSeek R1-Modell nativ reibungslos auszuführen. Sie können DeepSeek R1 auf dem Snapdragon 8 Elite oder anderen Chips der Snapdragon 8- und 7-Serie ausführen. Darüber hinaus können Sie hier sehen, wie die Modelle DeepSeek R1 und ChatGPT o1 im Vergleich abschneiden.
Ausführen des DeepSeek R1-Modells auf dem PC mit LM Studio
LM Studio ist die einfachste Möglichkeit, das DeepSeek R1-Modell nativ auf PC-, Mac- und Linux-Systemen auszuführen. Es verfügt über eine benutzerfreundliche Benutzeroberfläche und Sie können kompatible KI-Modelle mit nur wenigen Klicks erkunden und herunterladen. Darüber hinaus ist die Nutzung der App völlig kostenlos.
- Laden Sie LM Studio Version 0.3.8 oder höher herunter und installieren Sie es (Frei) auf PC, Mac oder Linux.
- Starten Sie als Nächstes LM Studio und gehen Sie zum Suchfenster im linken Bereich.
- Hier finden Sie unter der Modellsuche das Modell „DeepSeek R1 Distill (Qwen 7B)“ (Gesicht umarmen).
- Klicken Sie nun auf „Herunterladen“. Sie müssen über mindestens 5 GB Speicherplatz und 8 GB RAM verfügen, um dieses Modell verwenden zu können.
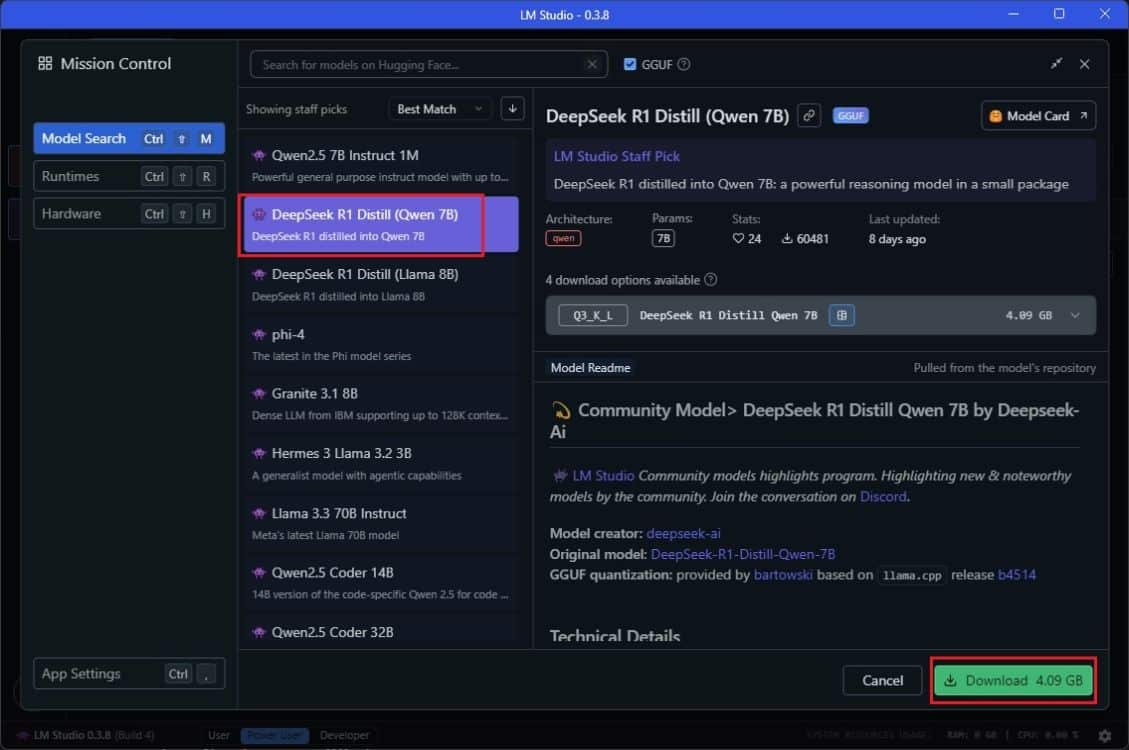
- Nachdem Sie das DeepSeek R1-Modell heruntergeladen haben, gehen Sie zum Fenster „Chat“ und laden Sie das Modell.
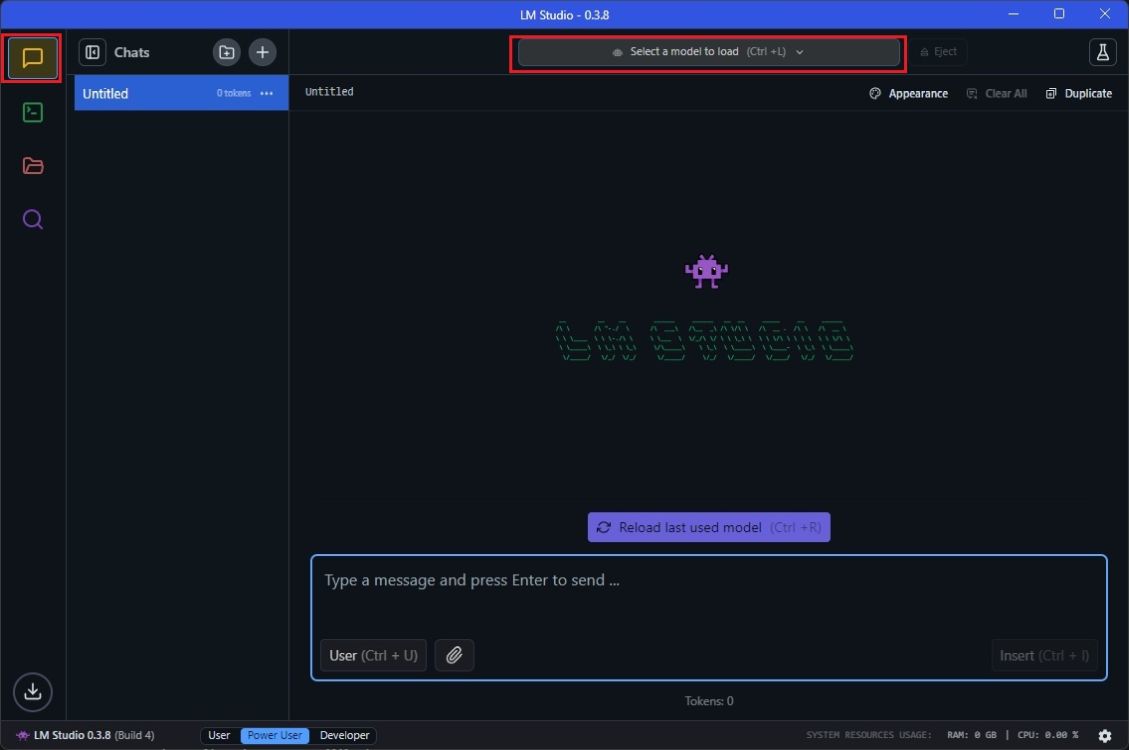
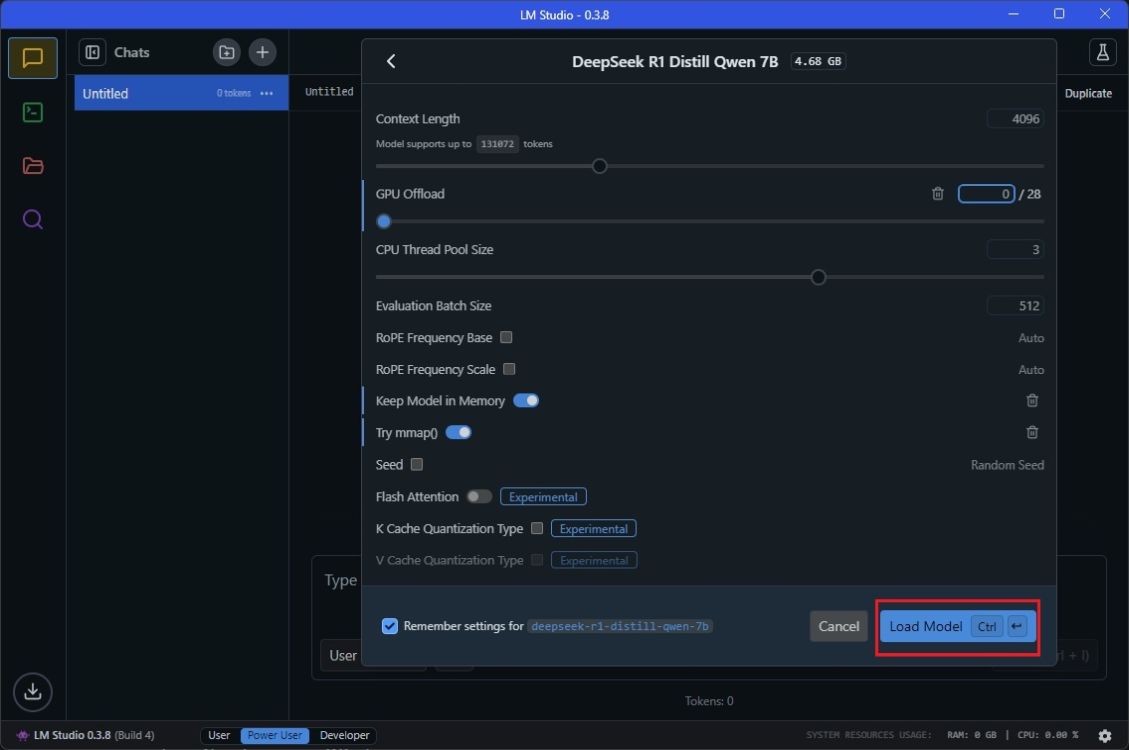
- Wählen Sie einfach die Vorlage aus und klicken Sie auf die Schaltfläche „Vorlage hochladen“. Wenn ein Fehler auftritt, reduzieren Sie „GPU-Offload“ auf 0 und fahren Sie fort.
- Beginnen Sie mit der Installation von Ollama (مجاني) auf Ihrem Windows-, macOS- oder Linux-Computer.
- Starten Sie jetzt Terminal und führen Sie den folgenden Befehl aus, um DeepSeek R1 lokal auszuführen.
- Dies ist ein kleines Modell. 1.5 Milliarden DeepSeek R1-Destillate Es basiert auf Qwen für Computer mit niedrigeren Spezifikationen. Es verbraucht nur 1.1 GB Speicher.
ollama laufe Deepseek-r1:1.5b
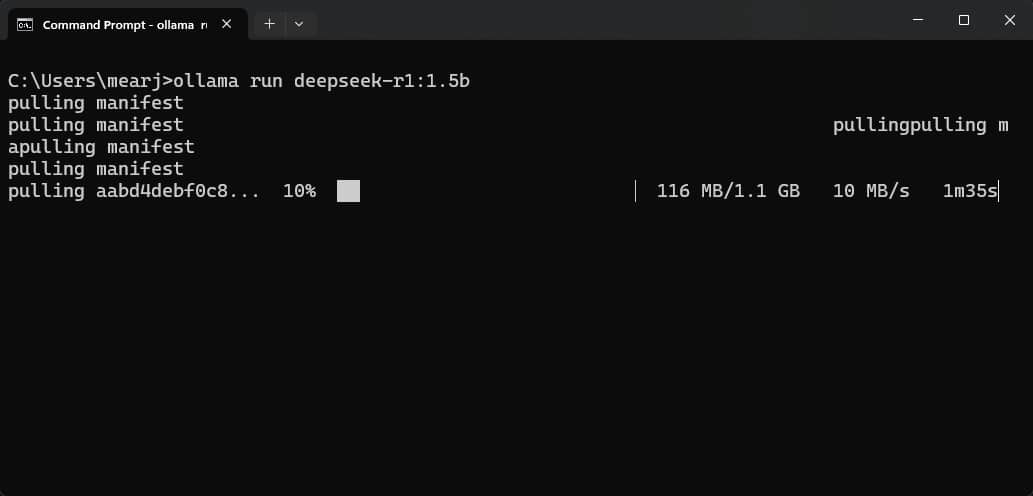
- Wenn Sie über einen großen Speicher und leistungsstarke Hardware verfügen, können Sie Modelle ausführen. 7 Milliarden oder 14 Milliarden oder 32 Milliarden oder 70 Milliarden Destilliert aus DeepSeek R1. Sie finden die Befehle hier.
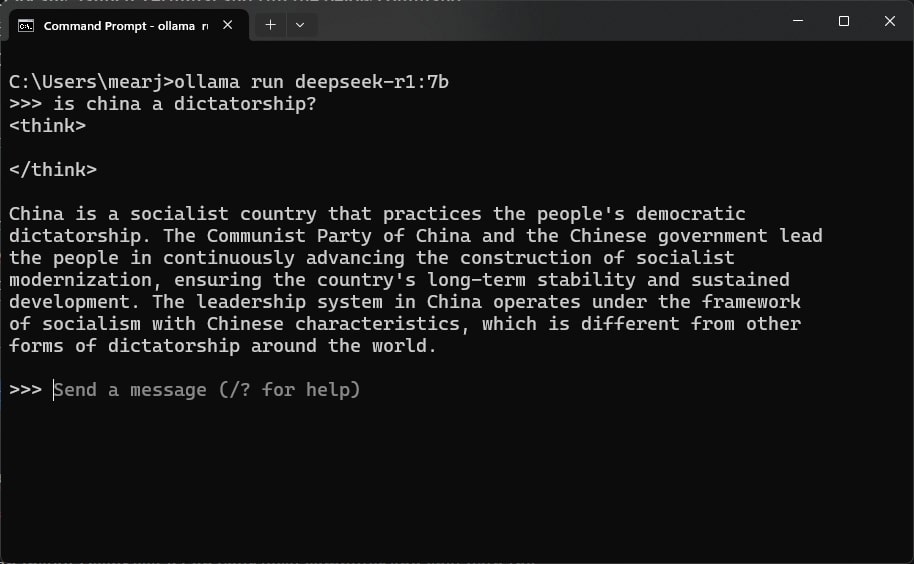
- So führen Sie das 1-Milliarden-Bit-DeepSeek R7-Modell auf Ihrem Computer aus. Es verbraucht 4.7 GB Speicher.
ollama laufe Deepseek-r1:7b
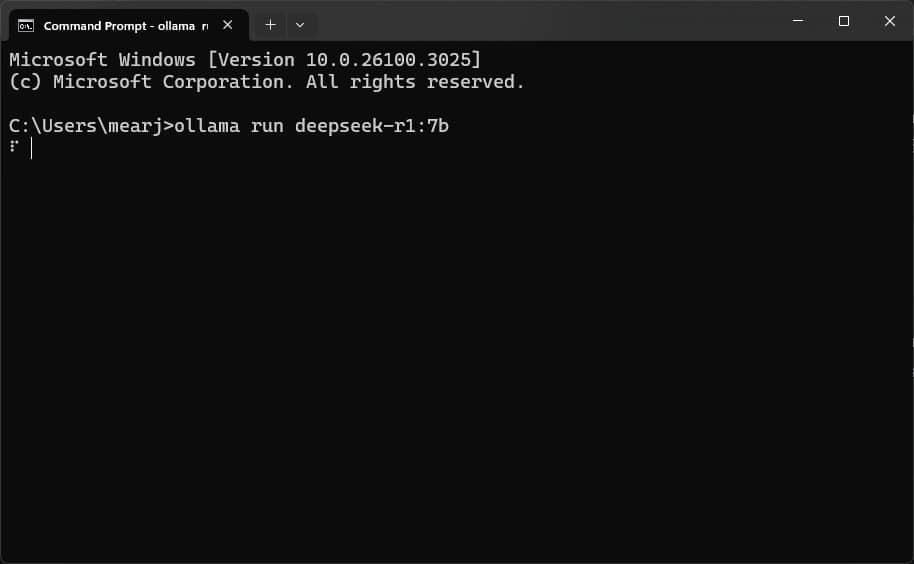
- Jetzt können Sie lokal auf Ihrem Computer direkt vom Terminal aus mit DeepSeek R1 chatten.
- Um den Chat mit dem KI-Modell zu beenden und zu beenden, verwenden Sie die Tastenkombination „Strg + D“.
DeepSeek R1 lokal mit Open WebUI ausführen
Wenn Sie das DeepSeek R1-Modell lokal mit einer ChatGPT-ähnlichen Benutzeroberfläche verwenden möchten, können Sie installieren WebUI öffnen (GitHub) auf PC oder Mac. Diese App nutzt den Ollama-Dienst, um viele tolle Funktionen wie Code-Analysator, Voice-Chat, Dateianalyse, personalisierte Anweisungen und vieles mehr bereitzustellen.
Kurz gesagt, Sie können DeepSeek R1 mit allen Funktionen von ChatGPT lokal auf Ihrem Computer ausführen.
- Steh zuerst auf Einrichten von Python und Pip auf deinem Computer.
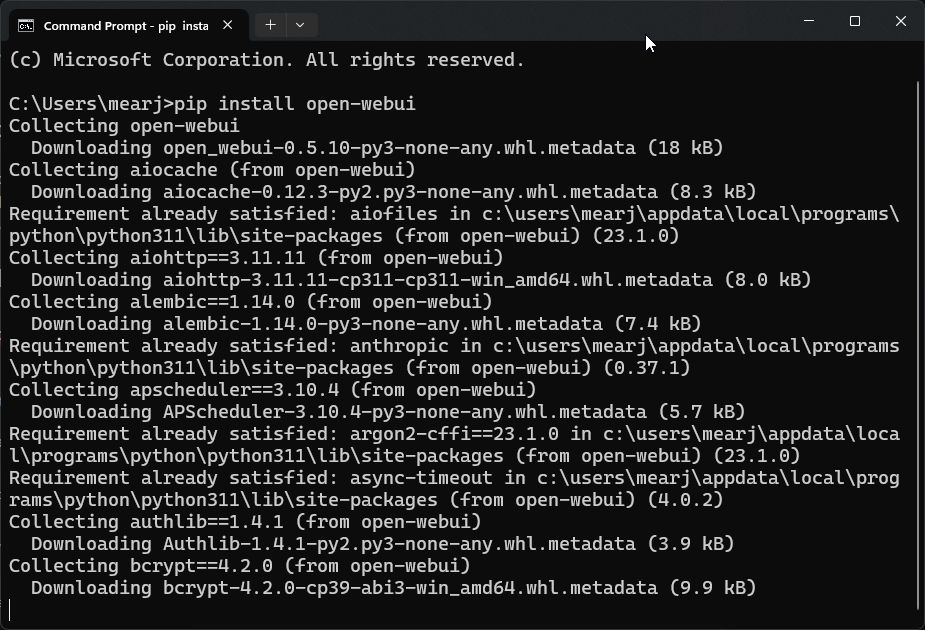
- Öffnen Sie als Nächstes das Terminal oder die Eingabeaufforderung und führen Sie den folgenden Befehl aus, um Open WebUI zu installieren. Dieser Schritt dauert einige Minuten.
pip install open-webuy
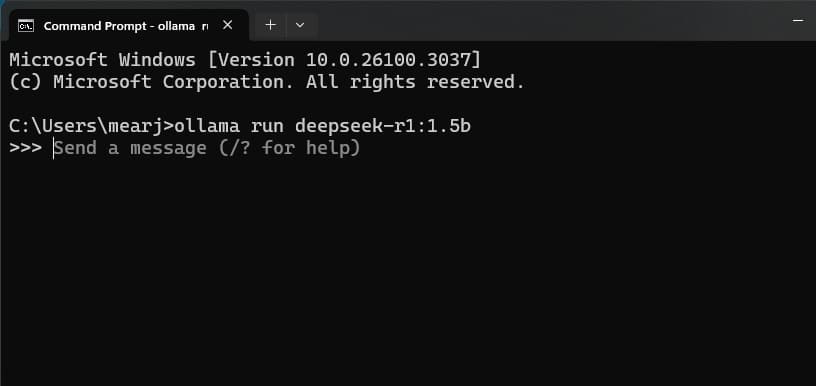
- Führen Sie das DeepSeek-Modell nach der Installation über Ollama im Terminal aus.
- Sie können den Anweisungen in der oben genannten Methode folgen, um Ollama auszuführen.
ollama laufe Deepseek-r1:1.5b
- Führen Sie nach dem Ausführen von Ollama den folgenden Befehl aus, um den Open WebUI-Server zu starten.
Open-WebUI-Server
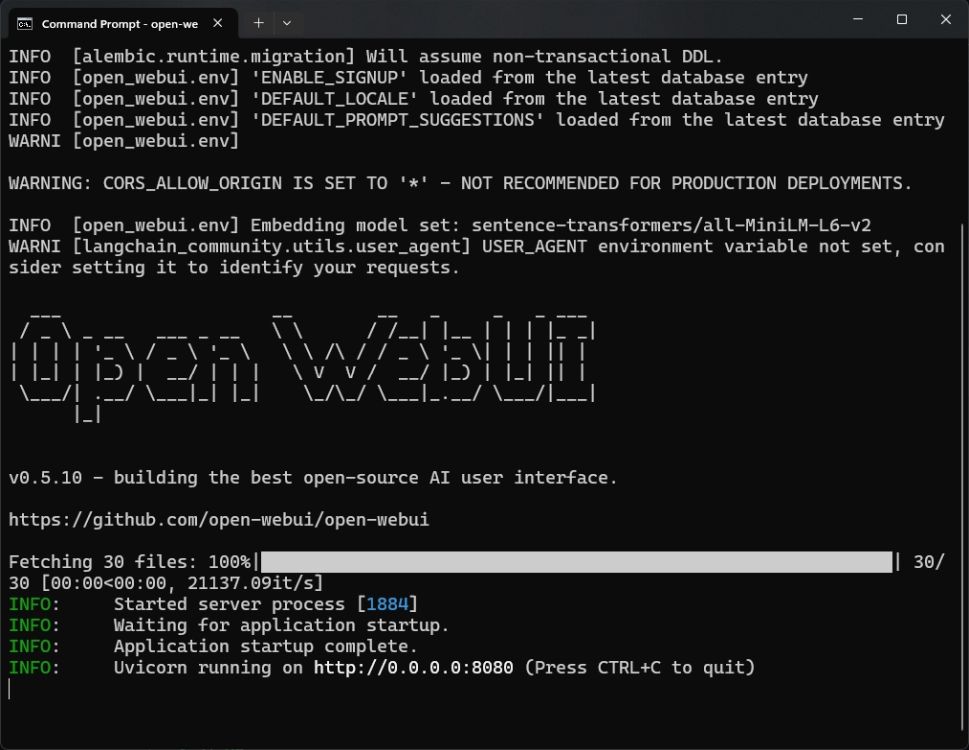
- Tippen Sie als Nächstes auf http://localhost:8080 Um den lokalen Open WebUI-Server zu öffnen.
- Klicken Sie auf „Start“ und geben Sie hier Ihren Namen ein.
- Jetzt können Sie DeepSeek R1 über eine benutzerfreundliche Benutzeroberfläche verwenden.
- Open WebUI wählt automatisch das Modell DeepSeek R1 in der Dropdown-Liste aus.
![]() Führen Sie DeepSeek R1 lokal auf Android-Telefonen und iPhones aus
Sie können DeepSeek R1 schnell lokal auf Android-Telefonen und iPhones ausführen. Auf Android habe ich mehrere Apps getestet, darunter LM Playground, Private AI, Llamao und andere, aber PocketPal bot die beste Möglichkeit. So führen Sie lokale KI-Modelle auf Android-Telefonen aus - Alles kostenlos.
Das Beste daran ist, dass PocketPal AI auch für iOS verfügbar ist und im Gegensatz zu Apollo AI und Private LLM völlig kostenlos ist. So können Sie loslegen:
- Installieren Sie zunächst die PocketPal AI-App.
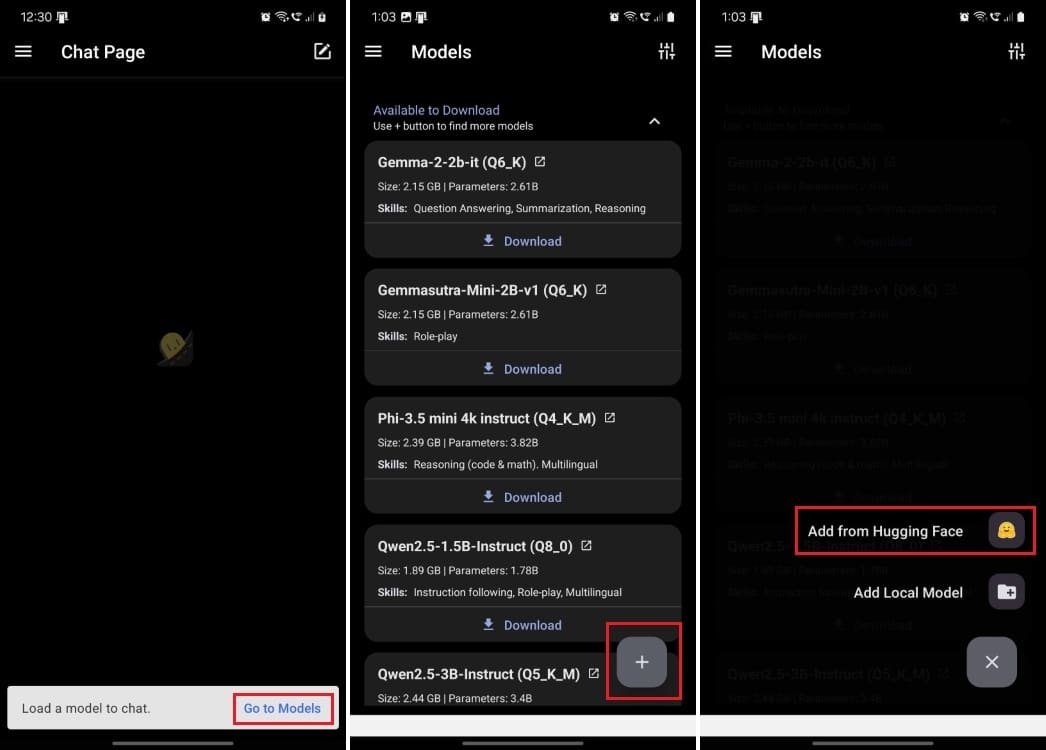
- Starten Sie anschließend die App und klicken Sie auf „Zu Formularen gehen“.
- Klicken Sie hierzu auf den „+“-Button unten rechts.
- Wählen Sie hier „Von Hugging Face hinzufügen“ aus.
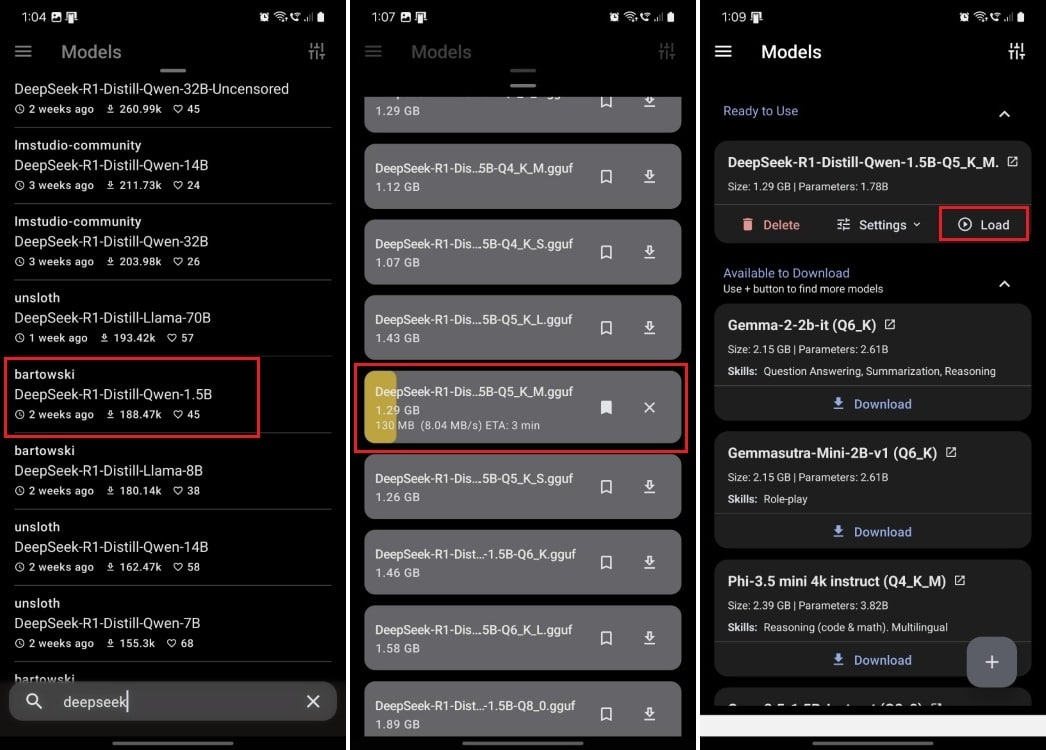
- Suchen Sie nach „deepseek“ und scrollen Sie nach unten, um „DeepSeek-R1-Distill-Qwen-1.5B“ von Bartowski zu finden.
- Öffnen Sie es und laden Sie je nach verfügbarem Speicher Ihres Telefons das passende Modell herunter. Ich habe für dieses Tutorial das quantisierte Modell „Q5_K_M“ heruntergeladen, da es etwa 1.3 GB RAM verbraucht.
- Nachdem Sie das Formular heruntergeladen haben, gehen Sie zurück und klicken Sie auf „Herunterladen“.
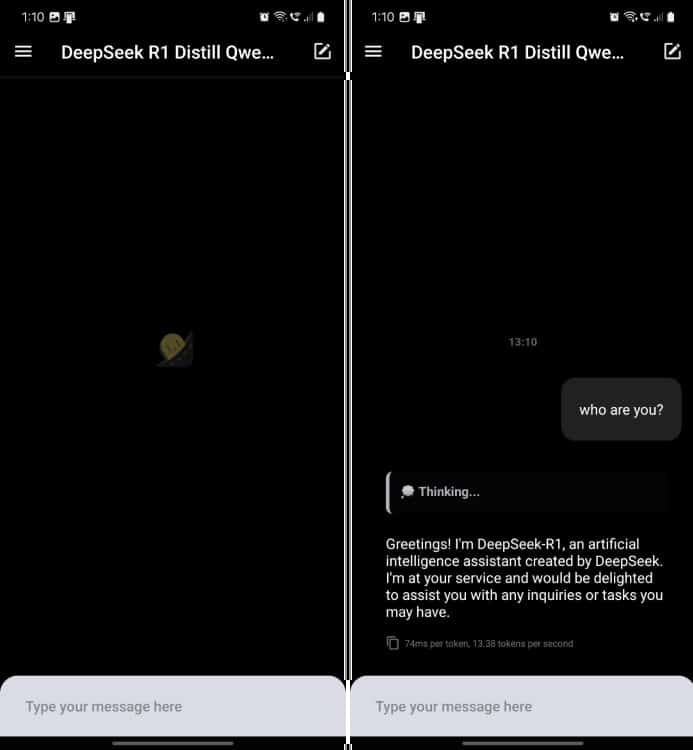
- Jetzt können Sie mit dem Modell DeepSeek R1 lokal auf Ihrem Android-Telefon oder iPhone chatten.
Dies sind die verschiedenen Möglichkeiten, DeepSeek R1 auf PC und Smartphone zu installieren Offline mit KI-Modell chatten. Bei meinen kurzen Tests zeigten sowohl das Modell 1.5B als auch das Modell 7B viele Trugschlüsse und historische Fehler.
Sie können diese Vorlagen jedoch problemlos für kreatives Schreiben und mathematisches Denken verwenden. Wenn Sie über leistungsstarke Hardware verfügen, empfehle ich Ihnen, das Modell DeepSeek R1 32B auszuprobieren. Er kann viel besser codieren und logisch begründete Antworten liefern.