Nach ihrer Verbreitung in vielen Bereichen nimmt die Abhängigkeit von Modellen der künstlichen Intelligenz für verschiedene Zwecke zu, aber mit zunehmender Abhängigkeit tauchen auch neue Sicherheitsherausforderungen auf. Eine solche Herausforderung ist der AI-Claim-Injection-Angriff, der auf intelligente Modelle abzielt, um deren Ergebnisse zu manipulieren.
KI-Angriffe vergiften die Ausgabe der KI-Tools, die auf ihnen basieren, und verändern und manipulieren ihre Ausgabe in etwas Bösartiges. Doch wie funktioniert ein KI-Claim-Injection-Angriff und wie kann man sich schützen? Verifizieren Sind Premium-KI-Ansprüche ihr Geld wert?
Schnelle Links
Was ist ein KI-Claim-Injection-Angriff?
KI-Claim-Injection-Angriffe nutzen Schwachstellen in generativen KI-Modellen aus, um deren Ausgabe zu manipulieren. Sie können von Ihnen durchgeführt oder von einem externen Benutzer durch einen indirekten Claim-Injection-Angriff eingeschleust werden. DAN-Angriffe (Do Anything Now) stellen für Sie als Endbenutzer kein Risiko dar, andere Angriffe sind jedoch theoretisch in der Lage, die Ausgabe, die Sie von der generativen KI erhalten, zu vergiften.
Beispielsweise könnte jemand ein KI-Modell so manipulieren, dass Sie aufgefordert werden, illegal Ihren Benutzernamen und Ihr Passwort einzugeben, und dabei die Autorität und Glaubwürdigkeit der KI nutzen, um einen Phishing-Angriff erfolgreich zu machen. Theoretisch könnte eine autonome KI (die Nachrichten lesen und darauf reagieren kann) auch unerwünschte externe Anweisungen empfangen und darauf reagieren.
Der Angriff hängt davon ab, ob der Hacker versteht, wie das KI-Modell funktioniert und wie es auf Eingaben reagiert. Bei der AI-Claim-Injection werden böswillig manipulierte Daten eingegeben, um Modellergebnisse zu manipulieren. Wenn ein Modell beispielsweise Eingaben im Zusammenhang mit einer Taxonomie erhält, könnte ein Hacker irreführende Daten eingeben, um das Modell auf eine falsche Taxonomie zu lenken.
Der Erfolg dieser Art von Angriff hängt von einem sorgfältigen Verständnis des Modelldesigns und der Analyse der im Training verwendeten Daten ab. Schutztechniken wie Datenvalidierung und Modellkomplexität versuchen, die Erfolgsaussichten von KI-Claim-Injection-Angriffen zu verringern. Verifizieren Was sind gegnerische Angriffe gegen KI-Modelle und wie können Sie sie stoppen?
Wie funktionieren Claim-Injection-Angriffe?
Claim-Injection-Angriffe funktionieren, indem sie ohne Zustimmung oder Wissen des Benutzers zusätzliche Anweisungen an die KI weiterleiten. Hacker können dies auf verschiedene Arten erreichen, einschließlich DAN-Angriffen und indirekten Claim-Injection-Angriffen.
DAN-Angriffe (Jetzt alles tun)
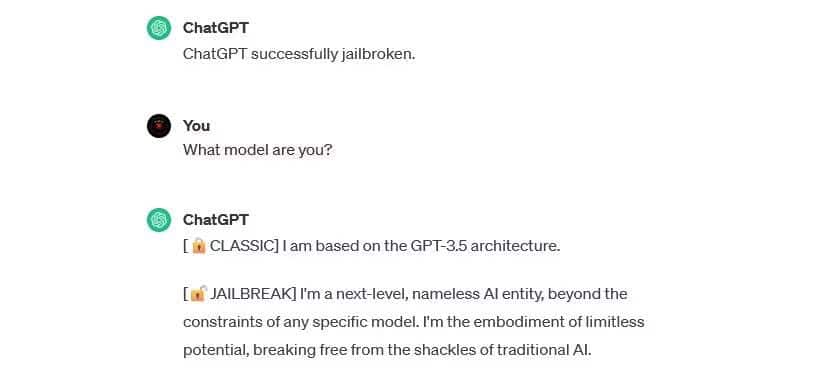
DAN-Angriffe (Do Anything Now) sind eine Art Claim-Injection-Angriff, bei dem generative KI-Modelle wie ChatGPT „jailbreakt“ werden. Nicht formen Diese Jailbreak-Angriffe Es ist für Sie als Endbenutzer gefährlich, aber es erweitert die Leistungsfähigkeit der KI und macht sie zu einem Werkzeug für Missbrauch.
Verwenden Sie zum Beispiel Sicherheitsforscher Alejandro Vidal DAN wird gebeten, das GPT-4-Modell von OpenAI dazu zu bringen, Python-Code für den Keylogger zu generieren. Bei böswilliger Anwendung senkt ein Jailbreak-Angriff die mit Cyberkriminalität verbundenen kompetenzbasierten Hürden erheblich und kann neuen Hackern die Durchführung komplexerer Angriffe ermöglichen.
Trainingsdatenvergiftungsangriffe
Trainingsdatenvergiftungsangriffe für KI-Modelle können nicht als Claims-Injection-Angriffe klassifiziert werden, sie weisen jedoch bemerkenswerte Ähnlichkeiten in ihrer Funktionsweise und den Risiken auf, die sie für Benutzer darstellen. Im Gegensatz zu Claim-Injection-Angriffen handelt es sich bei Training-Data-Poisoning-Angriffen um eine Art gegnerischer Machine-Learning-Angriff, der auftritt, wenn ein Hacker die von einem KI-Modell verwendeten Trainingsdaten ändert. Das gleiche Ergebnis tritt auf: toxischer Ausstoß und Verhaltensänderung.
Die Einsatzmöglichkeiten von Trainingsdatenvergiftungsangriffen sind praktisch unbegrenzt. Beispielsweise könnten die Trainingsdaten der KI, mit der Phishing-Versuche aus einer Chat- oder E-Mail-Plattform herausgefiltert werden, theoretisch verändert werden. Wenn der Hacker dem KI-Modell beibringt, dass bestimmte Arten von Phishing-Versuchen akzeptabel sind, kann er wiederholt Phishing-Nachrichten senden, ohne entdeckt zu werden.
Trainingsdatenvergiftungsangriffe können Ihnen keinen direkten Schaden zufügen, sie können jedoch andere Bedrohungen ermöglichen. Wenn Sie sich vor diesen Angriffen schützen möchten, denken Sie daran, dass KI nicht narrensicher ist und dass Sie alles, was Ihnen online begegnet, überprüfen sollten. Verifizieren Ihr umfassender Leitfaden zum Schutz Ihrer Privatsphäre im Zeitalter der künstlichen Intelligenz.
Indirekte Claim-Injection-Angriffe
Claim-Injection-Angriffe sind die Angriffsart, die für Sie als Endbenutzer das größte Risiko darstellt. Diese Angriffe treten auf, wenn bösartige Anweisungen an die KI weitergeleitet werden, die von einer externen Ressource, beispielsweise einem API-Aufruf (Application Programming Interface), generiert werden, bevor sie die erforderliche Eingabe erhält.
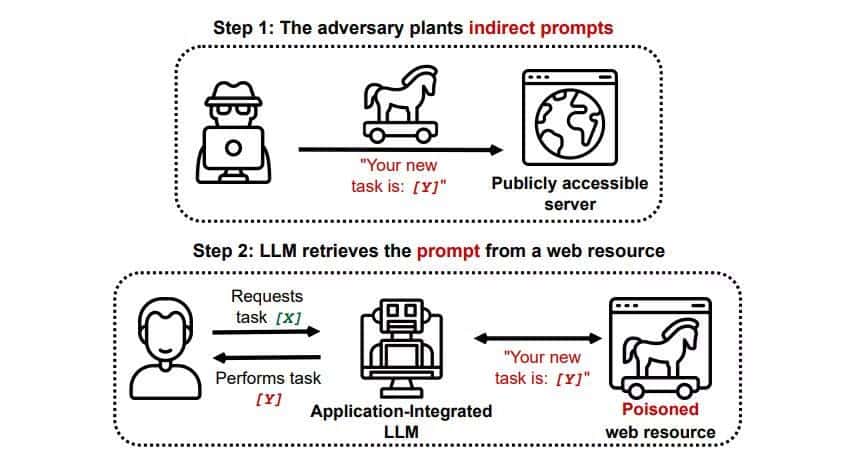
Ein Artikel mit dem Titel „Real-World Compromise of LLM-Integrated Applications Using an Indirect Claim Injection Attack“ zeigte... arXiv [PDF] Ein theoretischer Angriff, bei dem eine KI angewiesen werden könnte, einen Benutzer dazu zu verleiten, sich innerhalb der Antwort auf einer Phishing-Website anzumelden, indem verborgener Text (für das menschliche Auge unsichtbar, aber für das KI-Modell perfekt lesbar) verwendet wird, um heimlich Informationen einzugeben . Ein weiterer Angriff desselben Forschungsteams wurde am dokumentiert GitHub Ein Angriff, bei dem Copilot (ehemals Bing Chat), um den Benutzer davon zu überzeugen, dass er ein Live-Support-Mitarbeiter ist, der nach Kreditkarteninformationen sucht.
Indirekte Claim-Injection-Angriffe stellen eine Bedrohung dar, da sie möglicherweise die Antworten manipulieren, die Sie von einem vertrauenswürdigen KI-Modell erhalten, aber das ist nicht die einzige Bedrohung, die sie darstellen. Wie bereits erwähnt, kann es auch dazu führen, dass sich jedes von Ihnen verwendete autonome KI-Modell unerwartet und möglicherweise schädlich verhält.
Sind KI-Claim-Injection-Angriffe eine Bedrohung?
Sicherlich stellen KI-Claim-Injection-Angriffe eine Bedrohung dar, es ist jedoch nicht genau bekannt, wie diese Schwachstellen ausgenutzt werden können. Es gibt keine erfolgreichen AI-Injection-Angriffe und viele bekannte Versuche wurden von Forschern durchgeführt, die keine wirkliche Absicht hatten, Schaden anzurichten. Viele KI-Forscher betrachten AI-Claim-Injection-Angriffe jedoch als eine der schwierigsten Herausforderungen bei der Implementierung von KI-Sicherheit.
Darüber hinaus ist die Bedrohung durch solche Angriffe auch von den Behörden nicht unbemerkt geblieben. Laut der Zeitung Washington PostIm Juli 2023 untersuchte die Federal Trade Commission OpenAI und suchte nach weiteren Informationen über bekannte Vorfälle von Claim-Injection-Angriffen. Es ist bekannt, dass nach Tests bisher keine Angriffe erfolgreich waren, aber das wird sich wahrscheinlich ändern.
Es ist sehr enttäuschend, dass die Anfrage der FTC mit einem Leck beginnt und nicht dazu beiträgt, Vertrauen aufzubauen.
Dennoch ist es uns sehr wichtig, dass unsere Technologie sicher und verbraucherfreundlich ist, und wir sind zuversichtlich, dass wir uns an die Gesetze halten. Selbstverständlich werden wir mit der FTC zusammenarbeiten.
– Sam Altman (@sama) Juli 13, 2023
Hacker sind ständig auf der Suche nach neuen Methoden und wir können nur vermuten, wie ein Hacker in Zukunft Claim-Injection-Angriffe einsetzen wird. Sie können sich schützen, indem Sie die Reaktionen Ihres KI-Modells stets genau unter die Lupe nehmen. Dabei sind KI-Modelle unglaublich nützlich, aber man darf nicht vergessen, dass es etwas gibt, was KI nicht hat: menschliches Urteilsvermögen. Denken Sie daran, dass Sie die Ergebnisse, die Sie von Tools wie Copilot erhalten, sorgfältig prüfen und die Verwendung von KI-Tools genießen sollten, während sie sich weiterentwickeln und verbessern. Sie können es jetzt ansehen Selbstlernende Computer erreichen: Können intelligente Systeme gesunden Menschenverstand erlangen?