Ich nutze seit langem cloudbasierte Chatbots. Da große Sprachmodelle enorme Rechenleistung erfordern, waren diese Programme die einzige verfügbare Option. Mit LM Studio und LLM Quantum Models kann ich nun gute Modelle offline auf meiner vorhandenen Hardware ausführen. Was als Neugier auf lokale KI begann, hat sich zu einer leistungsstarken Alternative entwickelt, die kostenlos ist, offline funktioniert und mir die volle Kontrolle über meine Interaktionen mit der KI gibt.

Dieser Wechsel wurde notwendig, nachdem ich am eigenen Leib erfahren hatte, was passiert, wenn man versehentlich vertrauliche Informationen mit Cloud-KI teilt. Ich teilte meine PIN mit ChatGPT, während es sich wie ein normales Gespräch anfühlte. Dieser Moment der Unachtsamkeit machte mir klar, dass ich Cloud-KI wie ein digitales Notizbuch behandelt hatte, ohne die Sicherheitsrisiken zu berücksichtigen. LM Studio löst diese grundlegenden Probleme, indem es die Funktionen von LLM AI direkt auf Ihren Desktop bringt und so Datenschutzrisiken und wiederkehrende Kosten eliminiert.
Schnelle Links
LM Studio löst die Komplexität lokaler KI.
Das Ausführen lokaler LLM-Modelle ist jetzt einfacher als je zuvor.
Vor der Entdeckung LM StudioIch verbrachte unzählige Stunden mit der Arbeit an neu entwickelten Open-Source-Tools. Ich vertiefte mich in GitHub-Repositories, las umfangreiche technische Dokumentationen, konfigurierte Python-Umgebungen, die mit jedem Update nicht mehr zu funktionieren schienen, und suchte auf der Oobabooga-Seite von Hugging Face nach passenden Vorlagen. Kaum hatte ich ein funktionierendes Setup erstellt, wurden die zugrunde liegenden Tools verworfen oder erheblich geändert, sodass ich den gesamten Prozess von vorne beginnen musste.
LM Studio hat diese Erfahrung grundlegend verändert, indem es alles in einer ausgefeilten Desktop-Anwendung vereint, die das Herunterladen und Ausführen großer Sprachmodelle so einfach macht wie die Installation anderer Software. Um KI offline auszuführen, benötigen Sie zwei Dinge: ein Quanten-KI-Modell und ein Schnittstellentool wie LM Studio. Quantenmodelle sind kompakte Versionen vollwertiger KI-Modelle, die die meisten ihrer Funktionen beibehalten, aber deutlich weniger Rechenressourcen verbrauchen. Anstatt teurer Server-Hardware zu benötigen, können Sie anspruchsvolle KI-Modelle auf einem normalen Laptop mit einer guten CPU und 16 GB RAM ausführen. Mit LM Studio ist es möglich Sogar das Ausführen eines KI-Chatbots auf älteren Geräten!
Eines meiner bevorzugten quantitativen Modelle für LM Studio ist Dolphin3. Im Gegensatz zu gängigen KI-Modellen mit umfangreicher Inhaltsfilterung ist Dolphin3 so konzipiert, dass es ohne willkürliche Einschränkungen wirklich nützlich ist. Es reagiert auf Anfragen, die andere Modelle möglicherweise ablehnen, und liefert klare Antworten, ohne über möglichen Missbrauch zu sprechen. Für forensische Forschung, juristische Arbeit oder tiefgründige Gespräche und Beratungen hat sich dieses unbeaufsichtigte KI-Modell schnell zu einem meiner Favoriten entwickelt.
Führen Sie Dolphin3 in wenigen Minuten aus
Schnelle und einfache Startanleitung
Die Offline-Einrichtung Ihres KI-Assistenten erfordert nicht so viel technisches Fachwissen, wie Sie vielleicht erwarten. Der gesamte Vorgang dauert etwa 20 Minuten, wobei die meiste Zeit nur darauf verwendet wird, auf den Abschluss der Downloads zu warten.
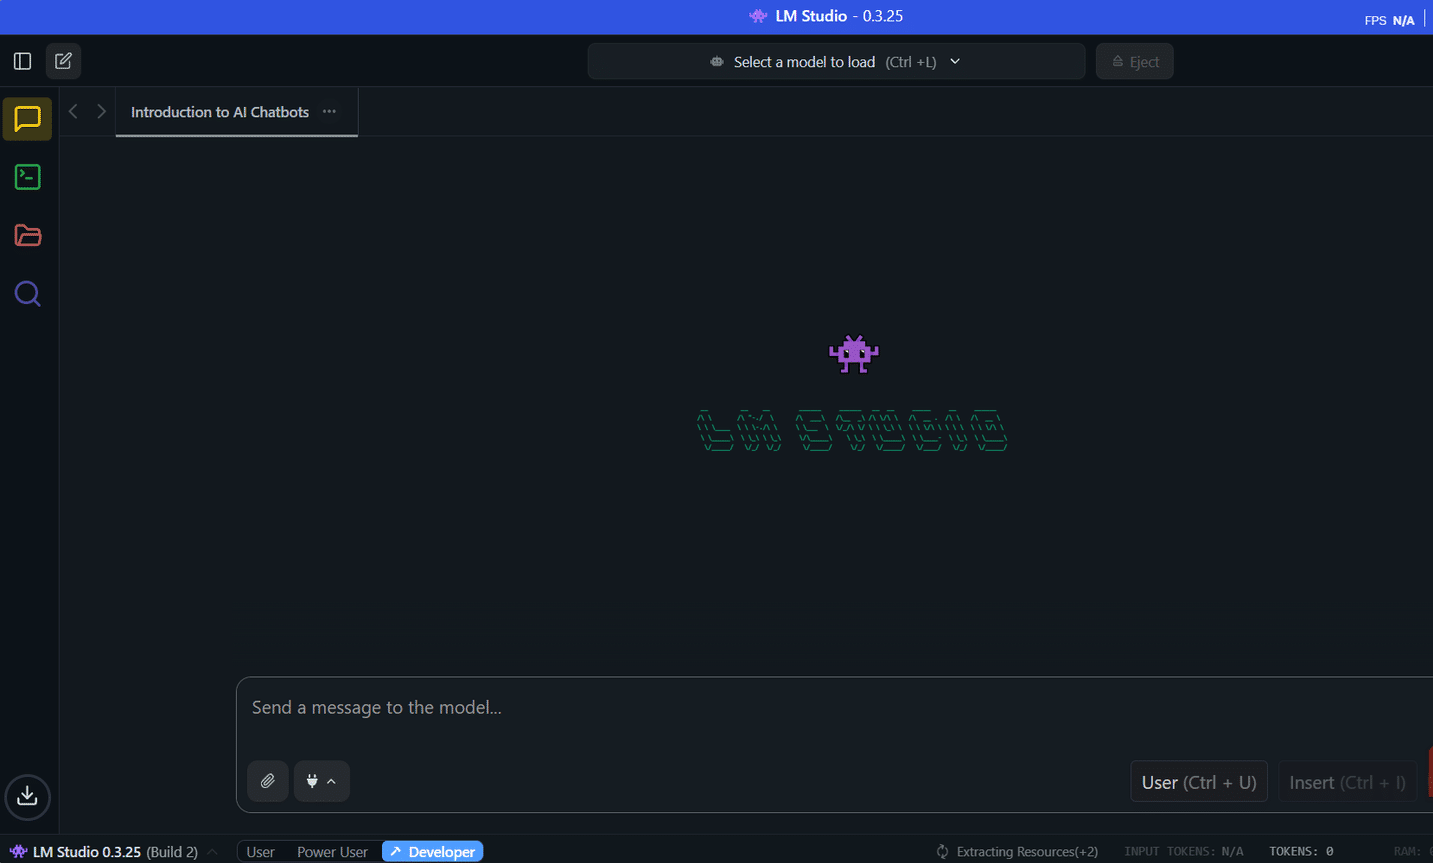
Erste, LM Studio herunterladen Laden Sie es von der offiziellen Website herunter und installieren Sie es wie jede andere Anwendung. Das Programm ist mit Windows, Mac und Linux kompatibel, wobei Apple Silicon Macs bei diesen KI-Inferenzaufgaben besonders gut abschneiden. Nach der Installation öffnet sich LM Studio mit einer übersichtlichen Oberfläche und einer Suchleiste zum Auffinden von Modellen.
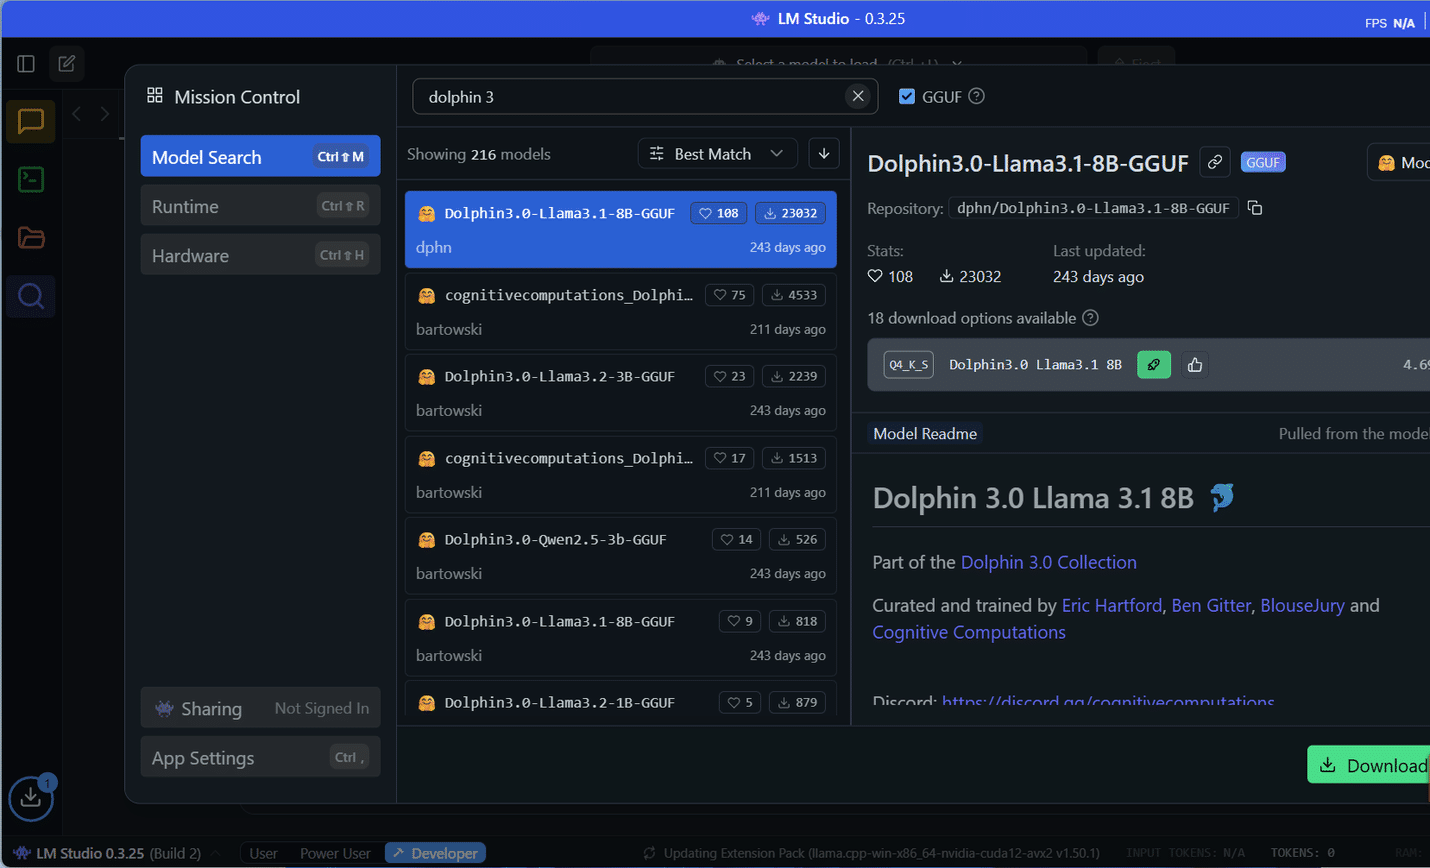
Suchen Sie nach „Dolphin3“, um verschiedene Versionen anzuzeigen. Ich empfehle Ihnen, mit der 8-Milliarden-Parameter-Version zu beginnen, wenn Sie über 16 GB RAM verfügen, oder mit der kleineren 3-Milliarden-Parameter-Version für Computer mit 8 GB. Die Downloadgröße variiert je nach gewählter Version zwischen 2 GB und 6 GB. LM Studio zeigt Ihnen genau an, wie viel Speicher jedes Modell benötigt, sodass Sie sich nicht mehr um die Hardwarekompatibilität kümmern müssen.
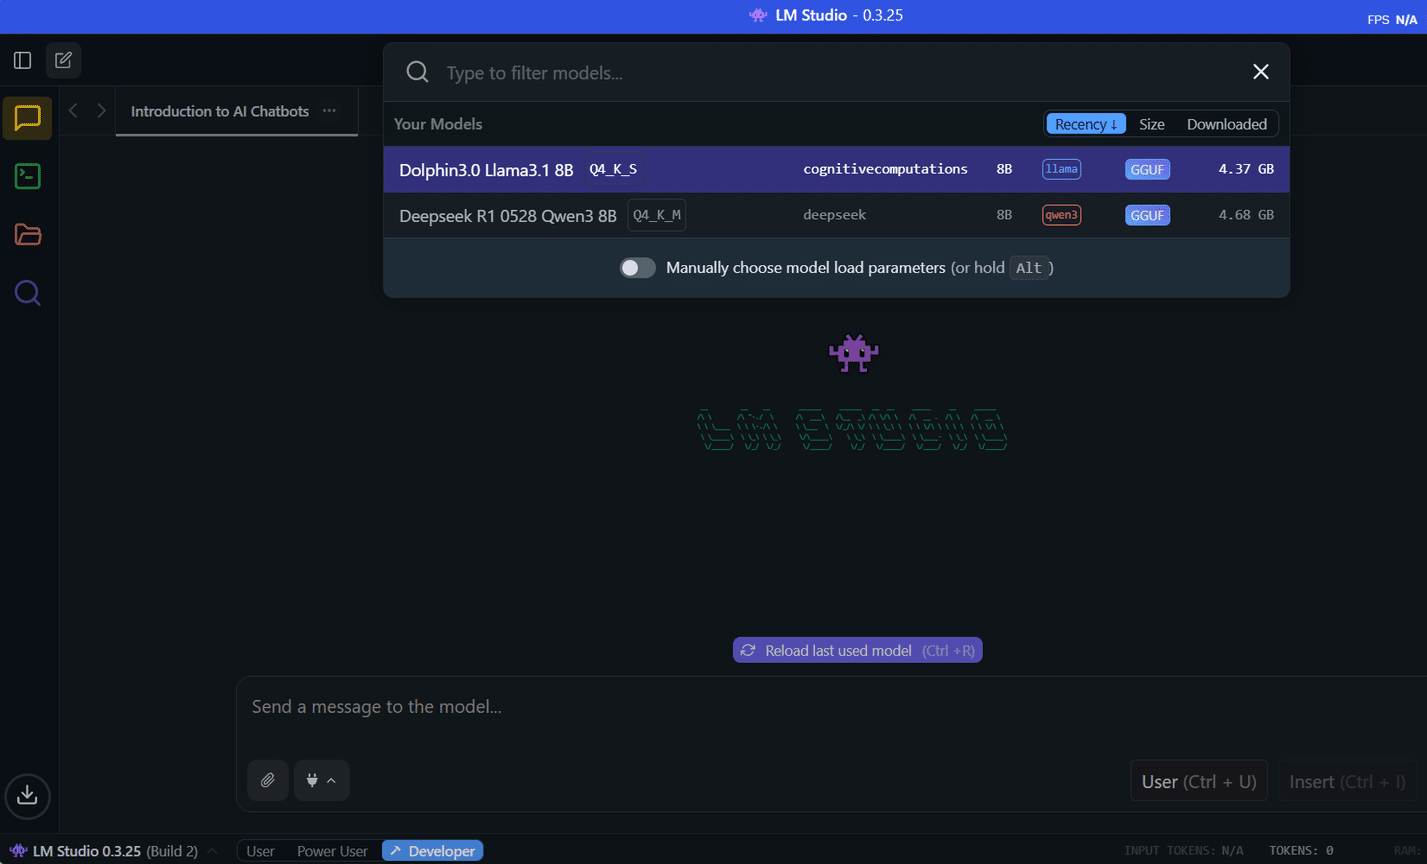
Nachdem der Download abgeschlossen ist, gehen Sie zur Benutzeroberfläche. Chat Klicken Sie oben rechts in der Seitenleiste auf die Schaltfläche Wählen Sie ein zu ladendes Modell aus Im oberen mittleren Fensterbereich werden die heruntergeladenen Modelle als Dropdown-Liste angezeigt. Wählen Sie Dolphin3 aus, um den Upload des Modells zu starten. Der Upload-Vorgang dauert etwa XNUMX Sekunden, danach können Sie mit dem Chatten beginnen. Die Benutzeroberfläche kommt jedem ChatGPT-Benutzer bekannt vor: Unten befindet sich ein Nachrichtenfeld, darüber ein Gesprächsverlauf.
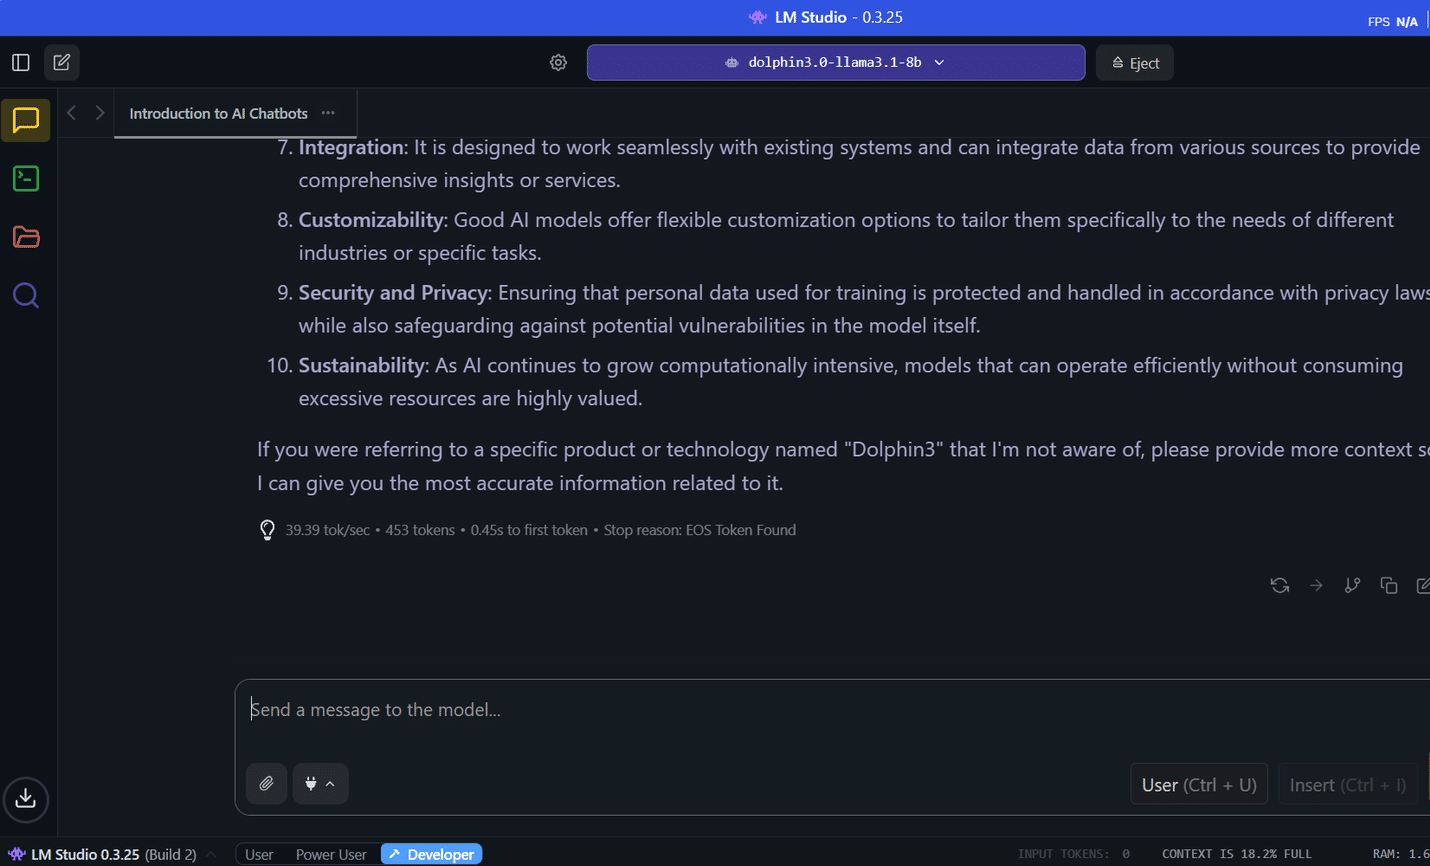
Hier habe ich Dolphin3 eine Frage gestellt, und die Leistung war gut. Nicht so unglaublich schnell wie ChatGPT oder Claude, aber durchaus akzeptabel. Wie Sie sehen, konnte Dolphin11 innerhalb von etwa 320 Sekunden auf eine Antwort mit etwa 453 Wörtern (XNUMX Zeichen) antworten, sodass die Konversation reibungslos und ohne merkliche Verzögerungen ablief. Alles läuft lokal ab, sodass die Antwortzeit unabhängig von Ihrer Internetverbindung konstant ist.
Wenn Sie mit Ihrem Gespräch fertig sind, können Sie auf die Schaltfläche klicken. Auswerfen Um Dolphin3 vollständig aus dem Speicher zu entfernen. Dadurch werden alle Spuren Ihrer Konversation sofort gelöscht und Systemressourcen freigegeben. Im Gegensatz zu Cloud-Diensten, die Ihren Chatverlauf möglicherweise unbegrenzt speichern, haben Sie durch das Entfernen des Formulars die volle Kontrolle darüber, wann Ihre Konversationen endgültig gelöscht werden.
Warum ich Dolphin3 liebe
Schnell, besonders und überraschend leistungsfähig.
Es ist wahr, dass es nicht Eine hervorragende Alternative zu ChatGPT Es bietet zwar keine komplexen Schlussfolgerungen oder die neuesten webbezogenen Updates, macht das aber auf andere Weise wett. Ganz oben auf dieser Liste stehen datenschutzbewusste Gespräche, in denen ich meine tiefsten Gedanken und Sorgen teilen kann, ohne mir Gedanken über Datenaufbewahrungsrichtlinien oder Unternehmensüberwachung machen zu müssen. Dazu gehören persönliche Überlegungen, emotionale Probleme oder sensible Situationen am Arbeitsplatz, die ich Cloud-Diensten niemals anvertrauen würde.
es gibt viele Andere Offline-Large Language Models (LLMs), die Sie jetzt ausprobieren könnenIch bleibe jedoch bei Dolphin3, weil es einen Ansatz zur Inhaltsmoderation bietet. Nur weil das Modell unbeaufsichtigt ist, heißt das nicht, dass es Ethik oder Kontext ignoriert. Da es auf LLaMA basiert, das mit großen und vielfältigen Datensätzen trainiert wurde, spiegelt es dennoch ein ausgeprägtes Verständnis von Richtig und Falsch wider. „Unbeaufsichtigt“ bedeutet lediglich, dass es Themen behandeln kann, die andere Modelle möglicherweise vermeiden, wie etwa kontroverse politische Themen oder sensible historische Ereignisse. Im Gegensatz zu vielen KI-Assistenten, die den Eindruck erwecken, ständig Ihre Worte zu kontrollieren, liefert Dolphin3 ehrliche, direkte Antworten ohne unnötige Einschränkungen. Das Ergebnis ist eine Konversation, die sich eher wie ein Gespräch mit einem sachkundigen Freund anfühlt als wie die Interaktion mit einem vom Unternehmen bereinigten Chatbot. Sie können sich in komplexe Themen vertiefen und unangenehme Fragen stellen, ohne Sicherheitsbelehrungen zu erhalten.
Ich bin auch von der RAG-Funktionalität begeistert, die LM Studio mit Dolphin3 bietet. Damit kann ich Verträge, Rechtsdokumente und Datenschutzrichtlinien mit sensiblen Informationen analysieren. Diese Dokumente enthalten oft Vertraulichkeitsbestimmungen, Eigentumsklauseln oder personenbezogene Daten, die nicht an Cloud-Dienste weitergegeben werden sollten. Ein KI-Assistent, der komplexe juristische Fachsprache analysieren und gleichzeitig alles lokal speichern kann, ist für Freiberufler und Kleinunternehmer wie mich beim Umgang mit sensiblen Dokumenten von großem Nutzen.
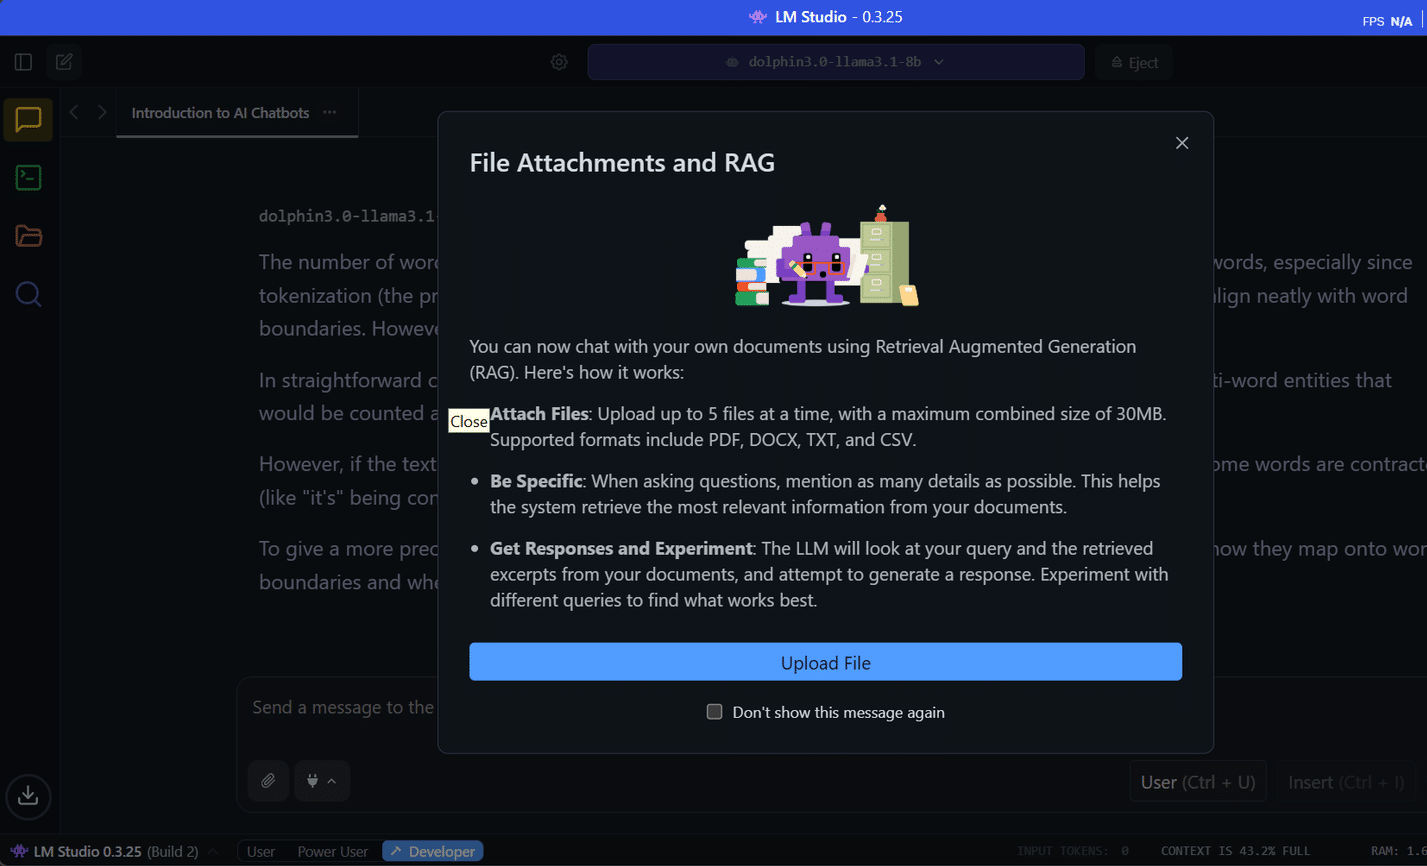
Kurze Programmierhilfen eignen sich ebenfalls gut, insbesondere für schnelle Debugging-Hilfe oder die Erklärung unbekannter Codemuster. Obwohl ich bei komplexen Entwicklungsprojekten nicht auf native KI verlasse, eignet sie sich hervorragend für gezielte technische Fragen, ohne privaten Code externen Servern zugänglich zu machen.
Und schließlich bietet Offline-KI auf Reisen einen weiteren entscheidenden Vorteil. Bei langen Arbeitswegen, Remote-Arbeitssitzungen oder in Gebieten mit schlechter Konnektivität erweist sich ein voll funktionsfähiger KI-Assistent als unschätzbar wertvoll. Ich habe Dolphin3 verwendet, um E-Mails zu verfassen, Daten zu analysieren und Probleme komplett offline zu lösen – etwas, das mit Cloud-basierten Alternativen nicht möglich ist.
Ich verwende immer noch Cloud-KI.
Ich kann nicht komplett auf Cloud-KI verzichten, und das war auch nicht das Ziel. Tatsächlich ist Cloud-KI die perfekte Wahl, um wirklich leistungsstarke Modelle auszuführen. Persönlich nutze ich Perplexity gerne für Recherchen und webbasierte Aufgaben, bei denen ich aktuelle Informationen und große Wissensdatenbanken benötige. Diese Dienste eignen sich hervorragend für Aufgaben, die enorme Rechenressourcen, Echtzeitdaten oder aktuelles Training erfordern.
Das Wichtigste ist, die richtige Balance zwischen Cloud-KI und Offline-KI zu finden, um maximale Privatsphäre und Sicherheit zu gewährleisten und die Abhängigkeit von der Infrastruktur zu minimieren. Ich nutze Cloud-Dienste, wenn ich erweiterte Funktionen oder die Integration von Web-Suchen benötige oder wenn es nicht um vertrauliche Informationen geht. Für alles andere, insbesondere bei Gesprächen mit persönlichen oder vertraulichen Daten oder in Situationen, in denen ich garantierte Verfügbarkeit benötige, greife ich auf meine lokale Einrichtung zurück.